웹 편집본 · 2026.11.10
내 주먹 속 사탕으로 상자 전체를 알 수 있을까요? — 기술통계와 추론통계의 기초
주먹으로 뽑은 사탕 몇 개(표본)로 상자 전체(모집단)를 말하려면 무엇이 필요할까요? 최빈값·중앙값·평균과 분산·표준편차를 R로 직접 계산하고, 평균의 함정과 표본으로 모집단을 추정하는 추론통계학의 출발점까지 잇는 77장 강의입니다.
발표의 주장·수치·인용과 시각자료를 보존하면서 제목과 흐름을 다듬은 웹 편집본입니다.발표 당시 원문 보관본도 별도로 제공합니다.
강의 전체 읽기
내 주먹에 쥔 사탕 몇 개로 사탕 상자 전체를 말할 수 있을까요? 뽑은 사탕을 있는 그대로 요약하는 기술통계학과, 그 패턴으로 상자 전체를 추정하는 추론통계학을 사탕 뽑기 비유로 구분합니다.
한림대학교 미디어스쿨 대학원 「커뮤니케이션조사방법론 II」 10주차 강의입니다. 2024년 학부 조사방법론 5주차 자료 두 편의 문구와 순서를 그대로 두고 한 편으로 합쳐 Achmage Presentation으로 다시 만들었습니다. 모집단과 샘플, 최빈값·중앙값·평균, 분산과 표준편차, 정규분포와 평균의 함정, t.test로 구한 신뢰구간을 다룹니다.
슬라이드의 R 코드는 R 4.3.3으로 실제로 실행한 결과를 함께 실었고, 연습 장의 결과는 다음 클릭에 나타납니다. 사탕 뽑기 시뮬레이터 장은 R Shiny 코드를 웹으로 옮긴 페이지로 연결되며, 표본을 10번·100번·1000번 쌓아 표본 비율이 모집단 비율을 중심으로 종 모양으로 모이는 모습을 볼 수 있습니다. 개념도는 Achmage Pele로 그렸고, 사진과 일러스트는 2024년 강의자료 원본입니다(원출처 미기재).
한국어 슬라이드와 전체 읽기, 영어 소개·읽기를 제공합니다.
01. 10W-1
커뮤니케이션 조사방법론 II (2026-2)
원본 화면의 보조 문구
01 / 77
10W-1 · 1/1
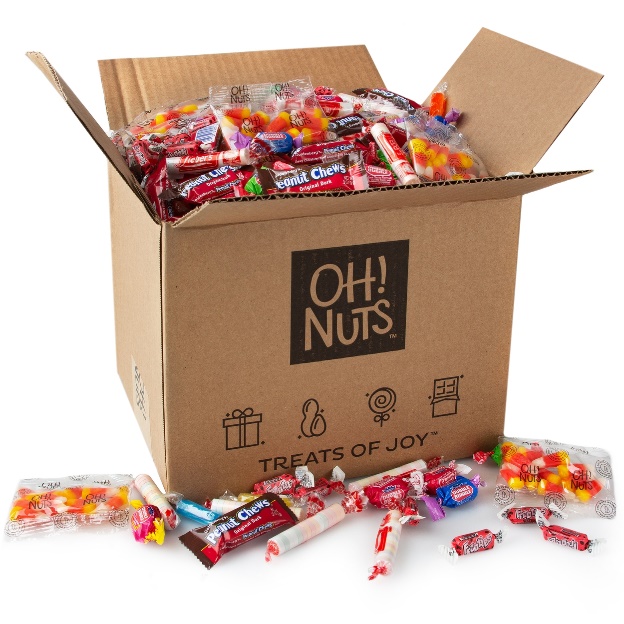
02. 모집단과 샘플 – 할로윈 랜덤 사탕 초콜릿 상자
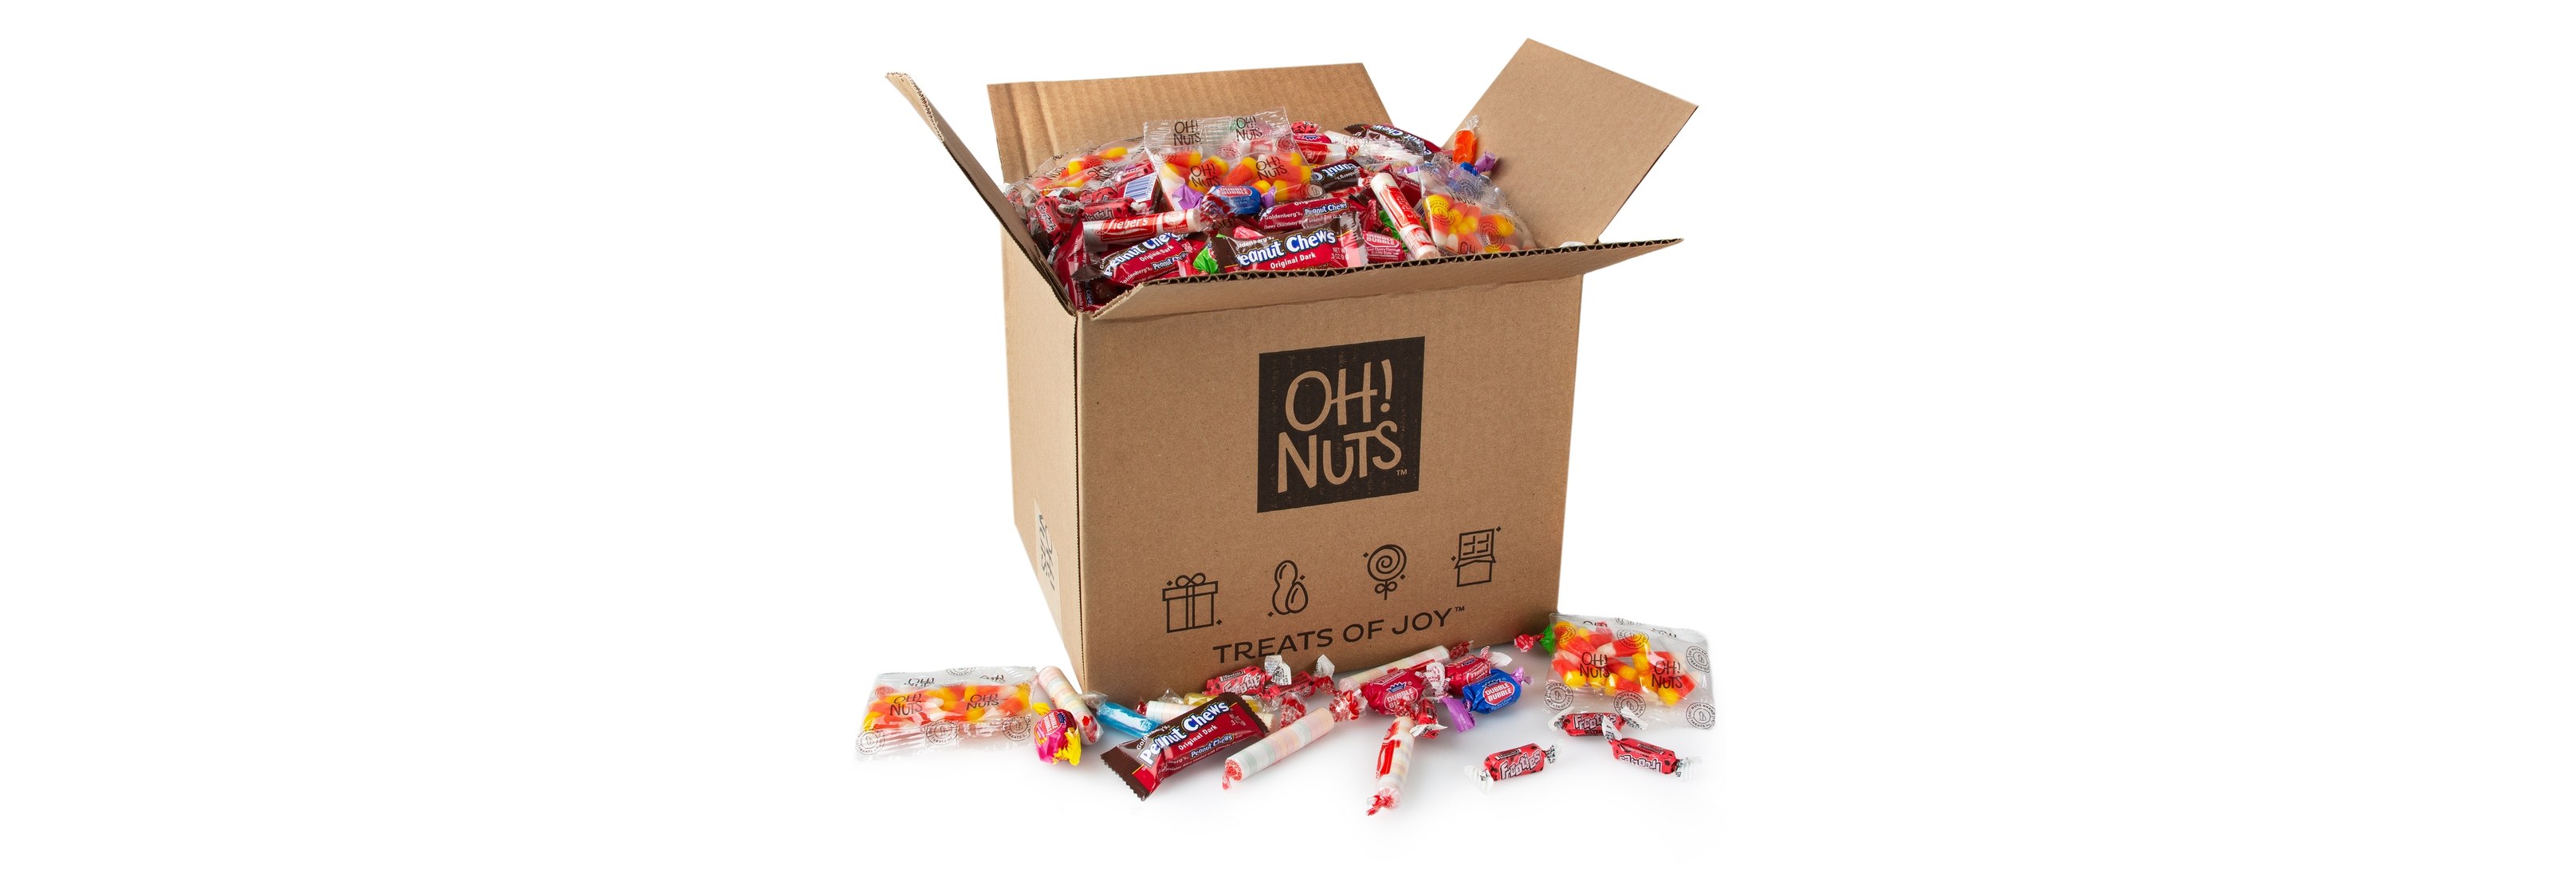
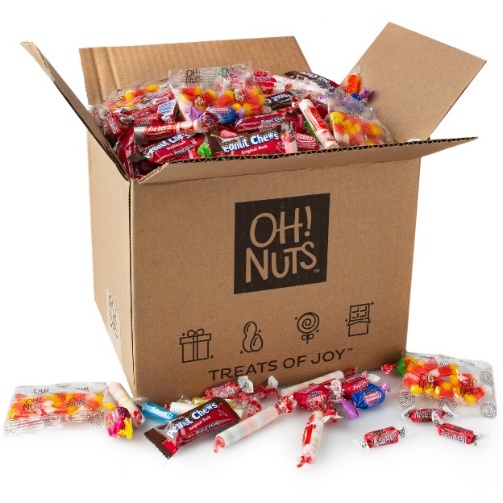
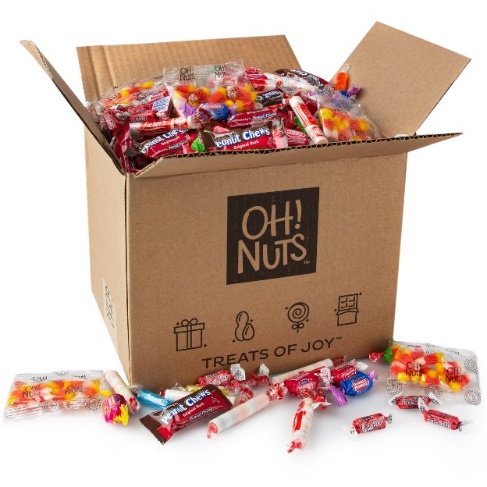
사탕과 초콜릿이 가득 든 할로윈 사탕 상자 사진
원본 화면의 보조 문구
02 / 77
모집단과 샘플 · 1/5
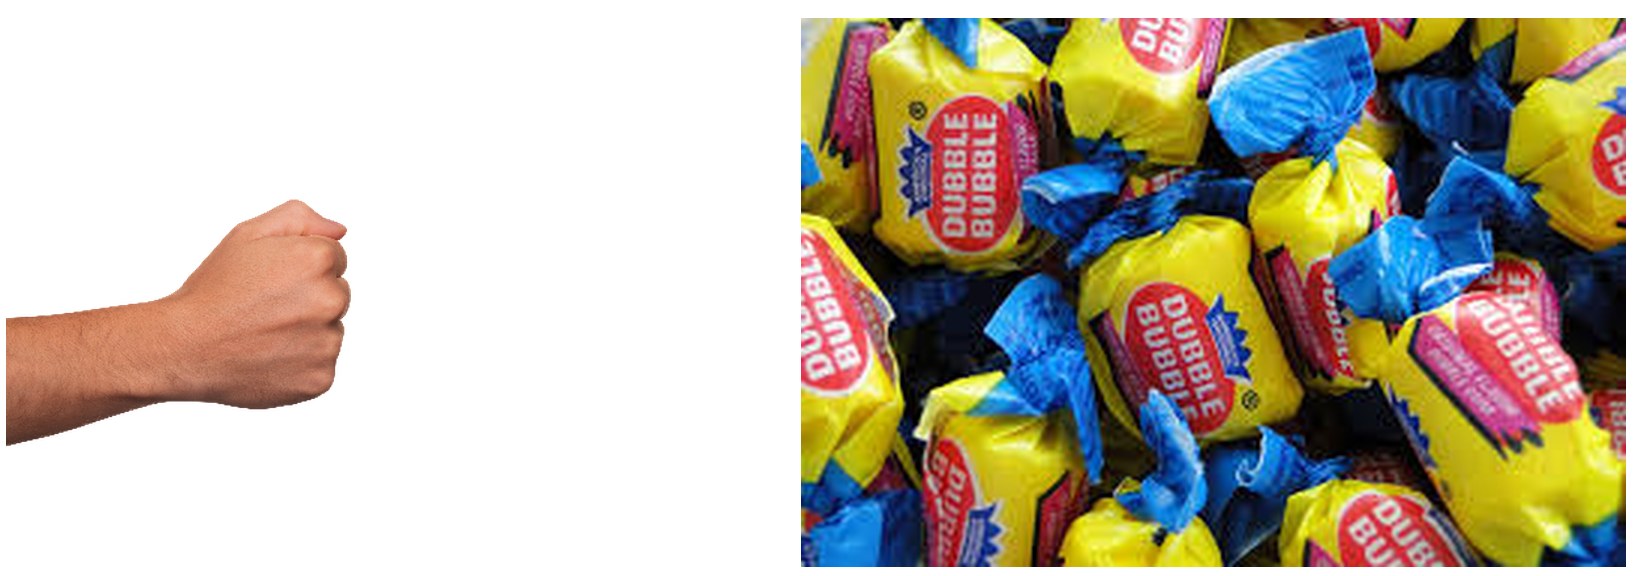
03. 주먹으로 사탕을 뽑아봅시다.
모집단
방법은 상관없다. 상자 전체에 들어있는 사탕의 정확한 비율이 뭐냐?
조금만 뽑을까?
샘플1
OR · 주먹이 터지게 가득 뽑을까?
샘플2
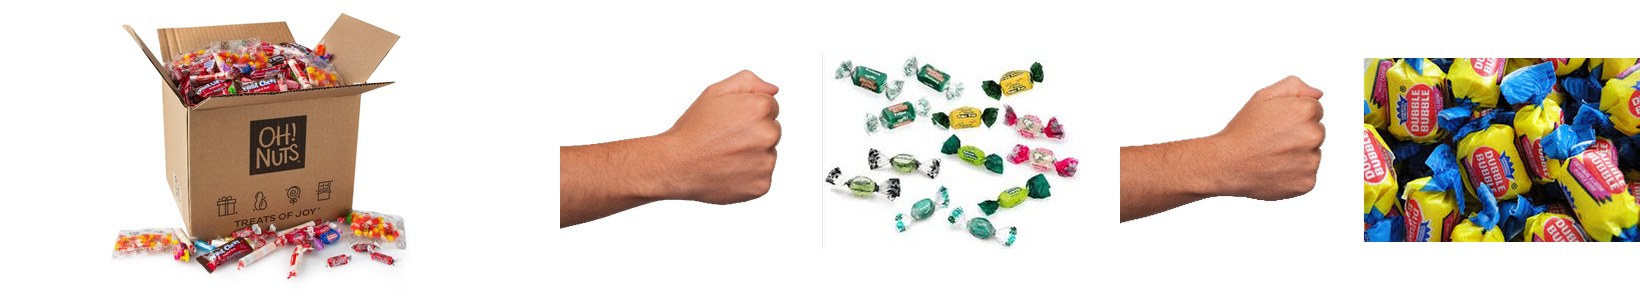
왼쪽부터 사탕이 가득한 상자(모집단), 주먹과 몇 개 안 되는 사탕(샘플1), 주먹과 가득 쌓인 풍선껌(샘플2) 사진
원본 화면의 보조 문구
03 / 77
모집단과 샘플 · 2/5
04. 주먹으로 사탕을 뽑아봅시다.
모집단
캔디상자 – 우리나라 인구 전체
조금만 뽑을까?
샘플1 – 1천명 설문조사
OR · 주먹이 터지게 가득 뽑을까?
샘플2 – 10만명 설문조사
왼쪽부터 사탕이 가득한 상자(모집단), 주먹과 몇 개 안 되는 사탕(샘플1), 주먹과 가득 쌓인 풍선껌(샘플2) 사진
원본 화면의 보조 문구
04 / 77
모집단과 샘플 · 3/5
05. 모집단과 샘플
모집단 : 연구자가 알고 싶어 하는 집단 전체 (예: “우리나라 인구 전체”)
샘플 : 모집단의 특성을 띄는, 연구자가 관찰 가능한 모집단의 부분집합 (예: “우리나라 인구전체…를 내가 일일히 다 알 수 없으니까 우리나라 인구 전체…중 1000명만 뽑은 것- 1000개의 샘플”)
나는 갑부가 아니라서 우리나라 전수 설문조사를 할수 없다 (모집단 전수조사 불가)
겨우 몇백만원 가지고 설문조사로 한 1000~2000명 설문조사는 할수 있다 (연구목적에 따른 샘플 추출)
내가 모은 그 1000~2000명 데이터로 우리나라 전체 모집단을 추정 가능하게 해주는 것이 바로 통계학이다 (샘플을 통한 모집단 추정)
원본 화면의 보조 문구
05 / 77
모집단과 샘플 · 4/5
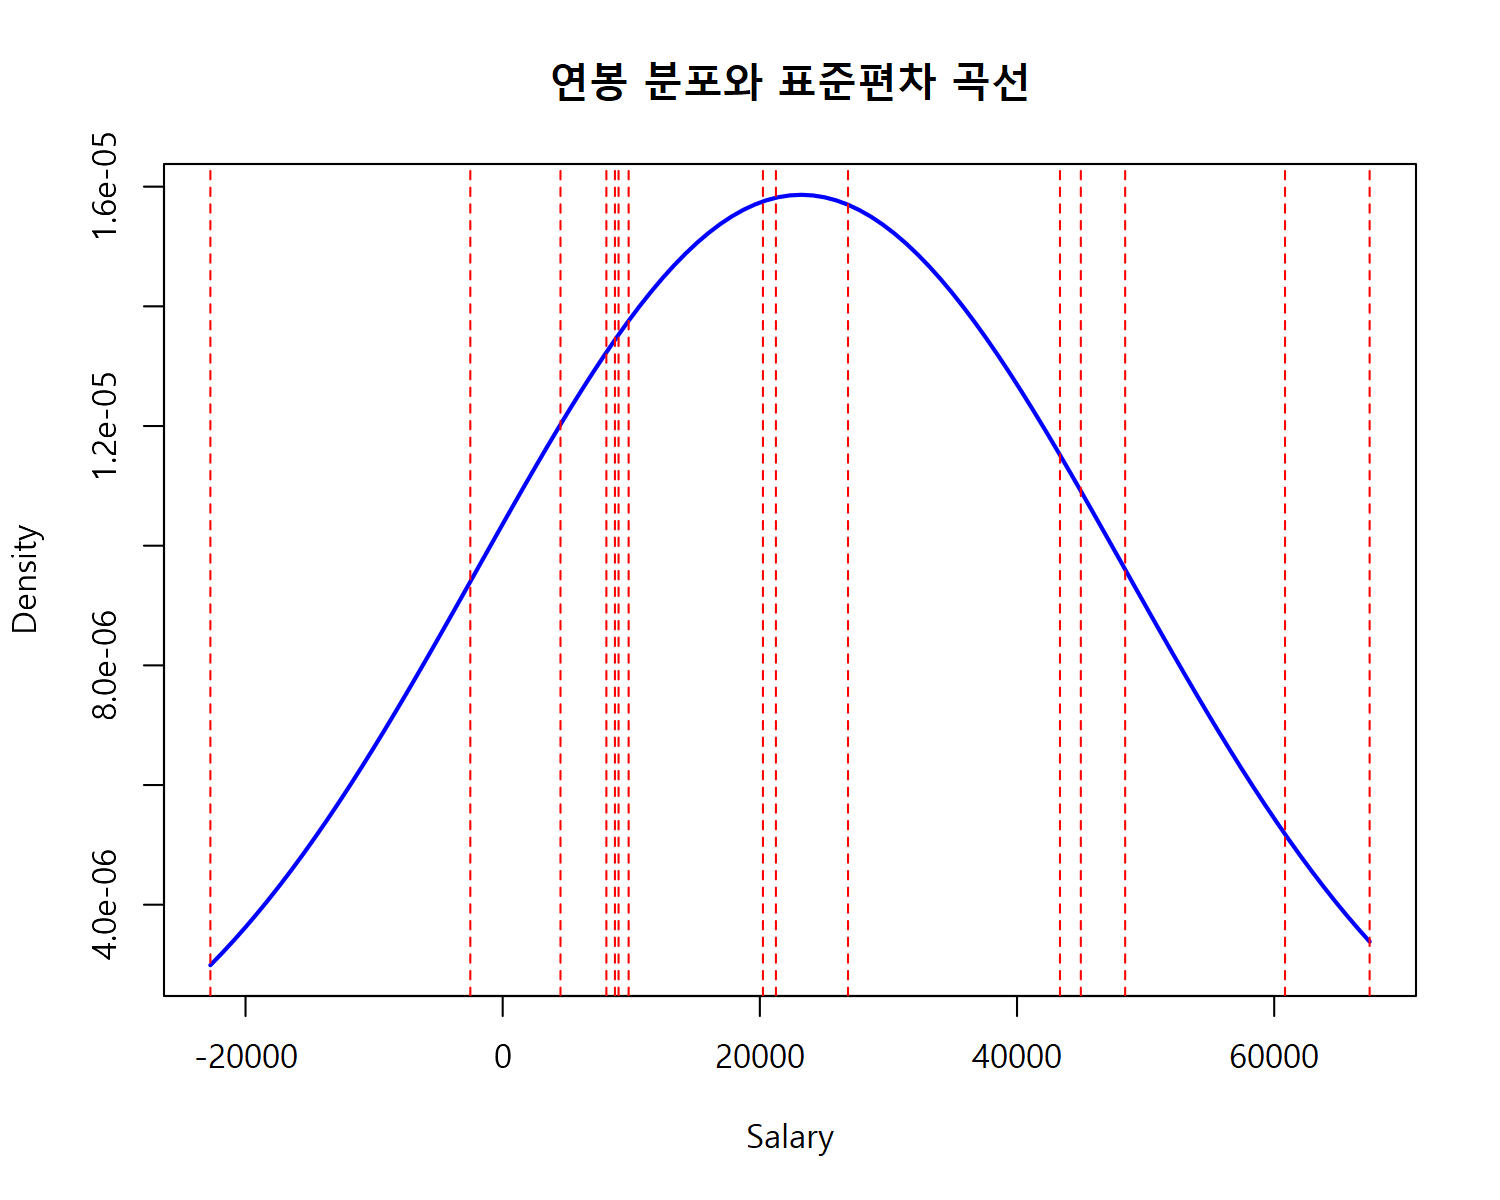
06. 기술통계학과 추론통계학
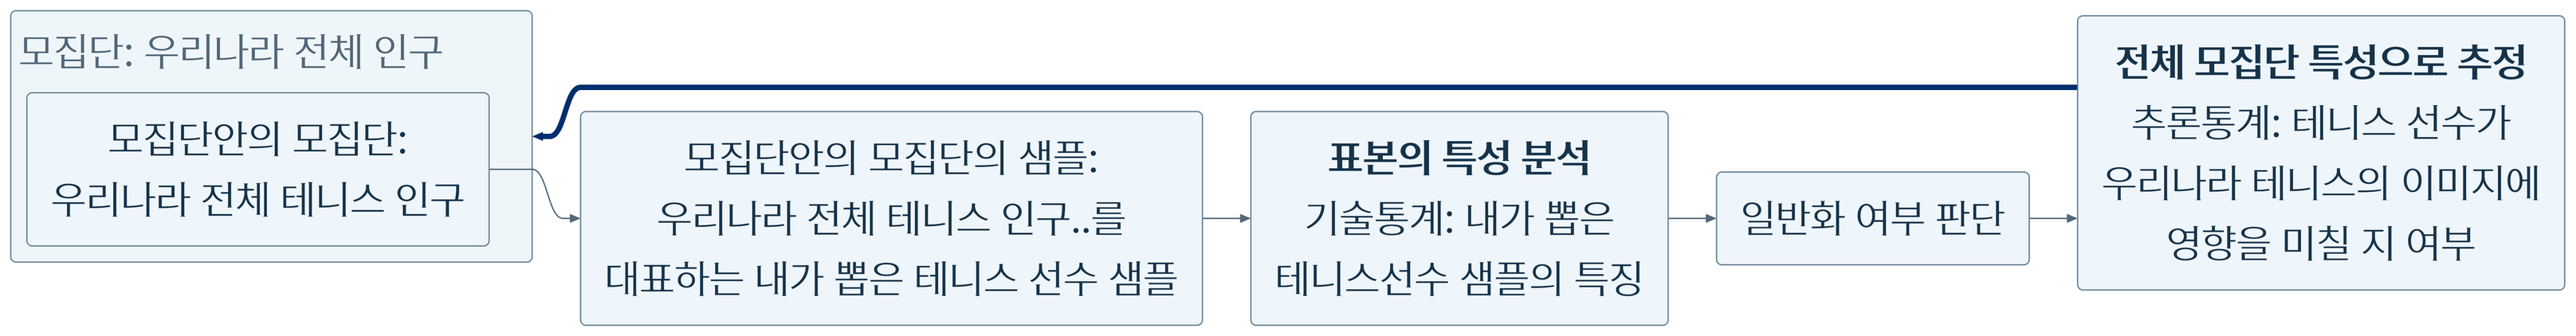
바깥 상자 “모집단: 우리나라 전체 인구” 안에 “모집단안의 모집단: 우리나라 전체 테니스 인구”가 있다. 테니스 인구에서 “모집단안의 모집단의 샘플: 우리나라 전체 테니스 인구..를 대표하는 내가 뽑은 테니스 선수 샘플”로 화살표가 간다. 샘플에서 “표본의 특성 분석”(기술통계: 내가 뽑은 테니스선수 샘플의 특징)으로, 다시 “일반화 여부 판단”을 거쳐 “전체 모집단 특성으로 추정”(추론통계: 테니스 선수가 우리나라 테니스의 이미지에 영향을 미칠 지 여부)으로 이어지고, 마지막 화살표가 모집단으로 돌아간다.
원본 화면의 보조 문구
06 / 77
모집단과 샘플 · 5/5
07. 기술통계학이란?
원본 화면의 보조 문구
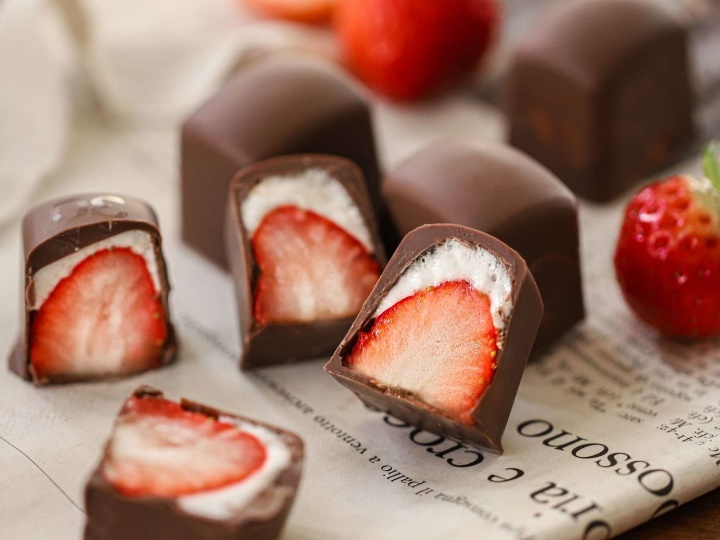
07 / 77
기술통계학 · 1/8
08. 기술통계학
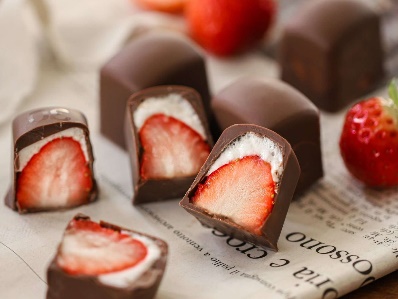
기술통계학(Descriptive Statistics)
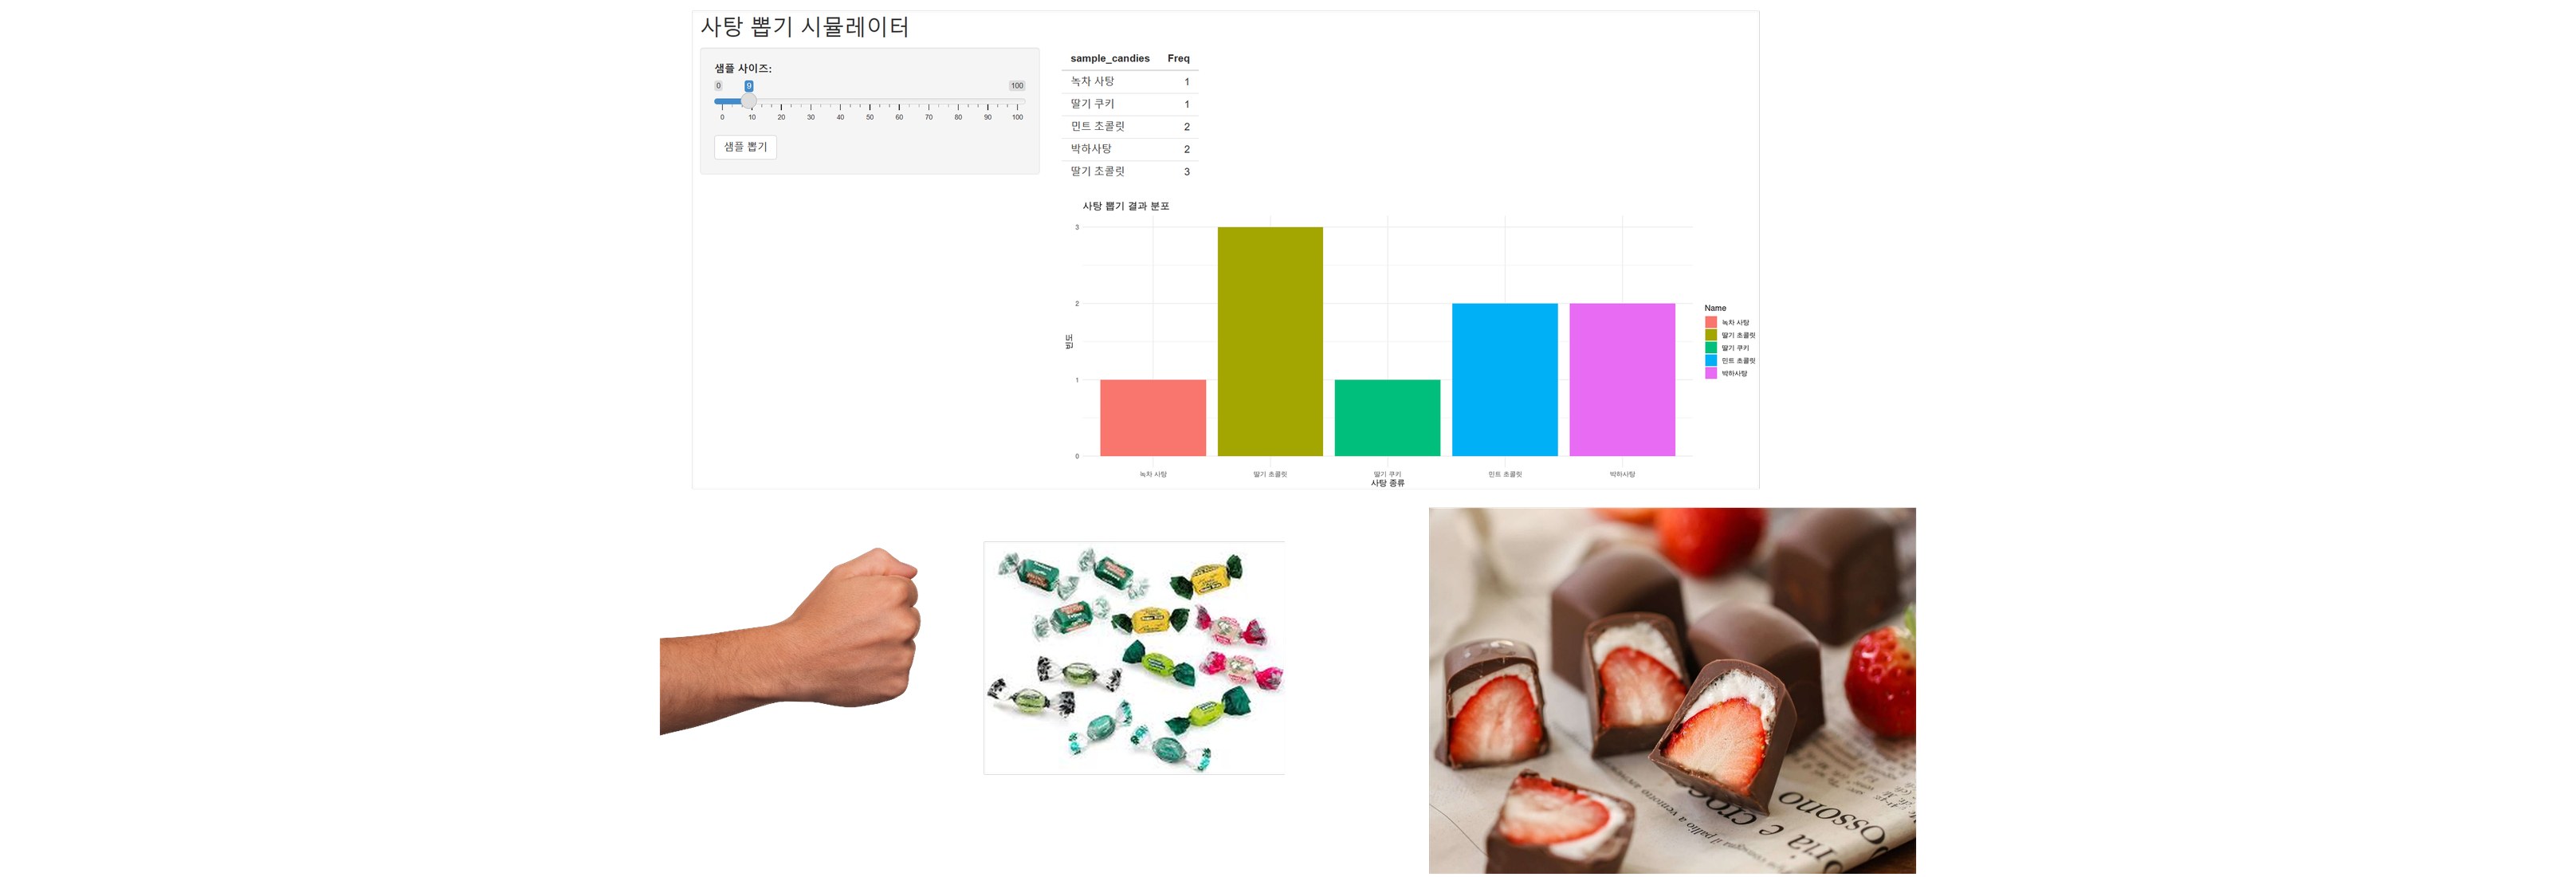
- 측정이나 실험에서 수집한 자료의 정리, 표현, 요약, 해석 등을 통해 자료의 특성을 규명하는 통계적 방법
- 모집단 전체 혹은 표본(sample: 모집단 일부)으로부터 얻은 데이터에 대한 숫자 요약(합계, 평균, 분산, 중앙값 등)이나 그래프 요약을 통하여 데이터가 가진 정보를 정리하는 방법
- 자료의 기초 통계적인 정보를 토대로 자료의 특성을 설명
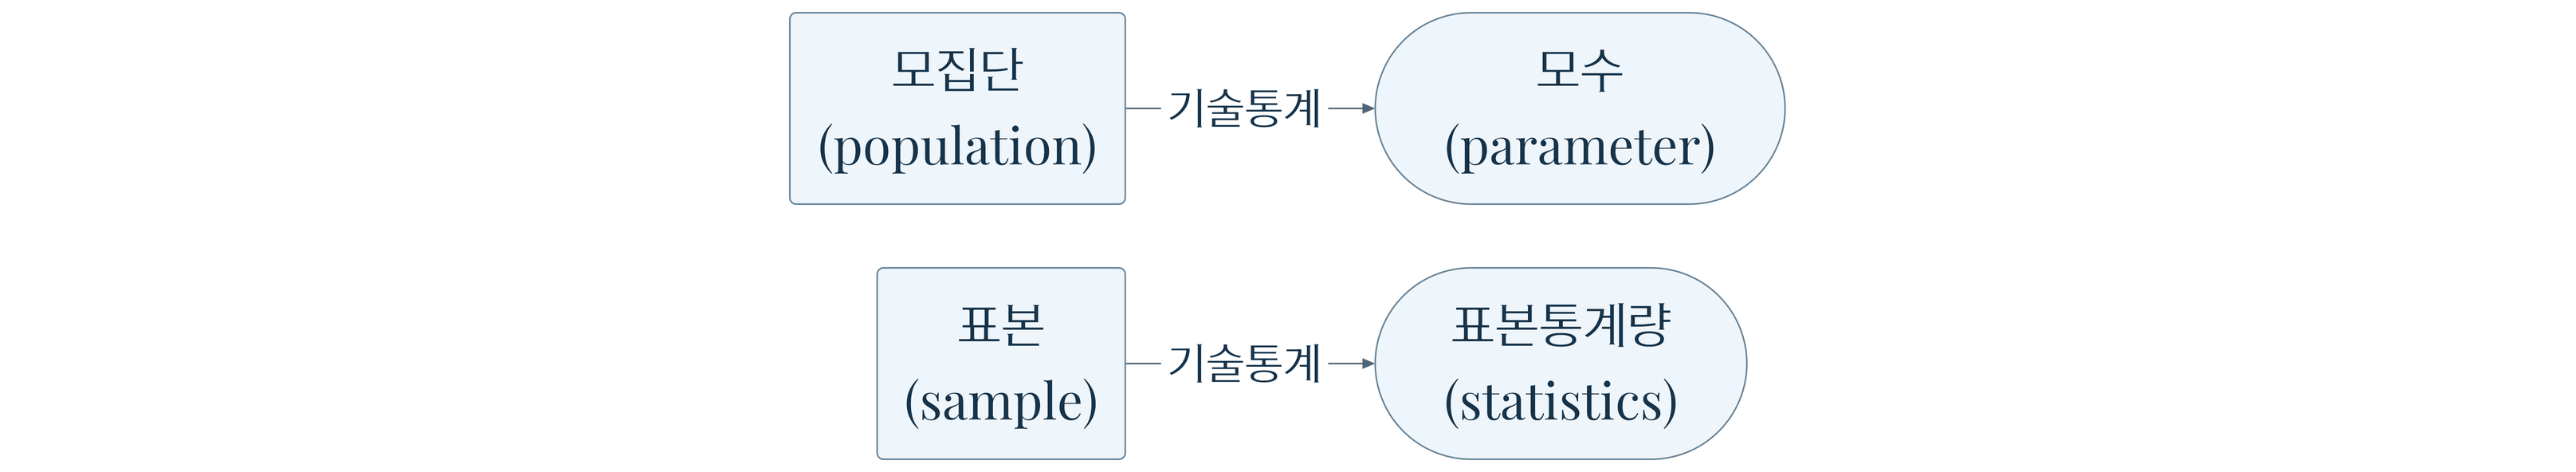
위 줄은 “모집단 (population)”에서 “모수 (parameter)”로, 아래 줄은 “표본 (sample)”에서 “표본통계량 (statistics)”으로 화살표가 간다. 두 화살표 모두 “기술통계”라고 표시되어 있다.
원본 화면의 보조 문구
08 / 77
기술통계학 · 2/8
09. 기술통계학
기술통계학(Descriptive Statistics)
- 자료를 있는 그대로 설명하는 것
- 3줄요약…이 아닌 (주로) 한 줄 요약
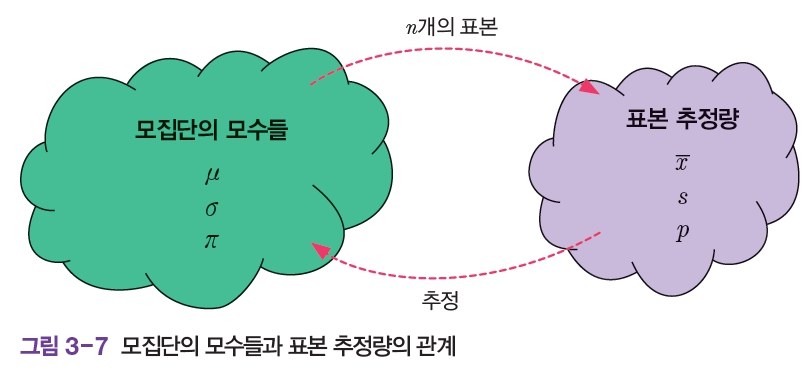
원본 화면의 보조 문구
09 / 77
기술통계학 · 3/8
10. 모집단과 샘플 – 사탕뽑기 시뮬레이터
내가 주먹으로 뽑은건 딸기 초콜릿만 몰아서 나왔는데 – 박스에는 골고루 있던데?
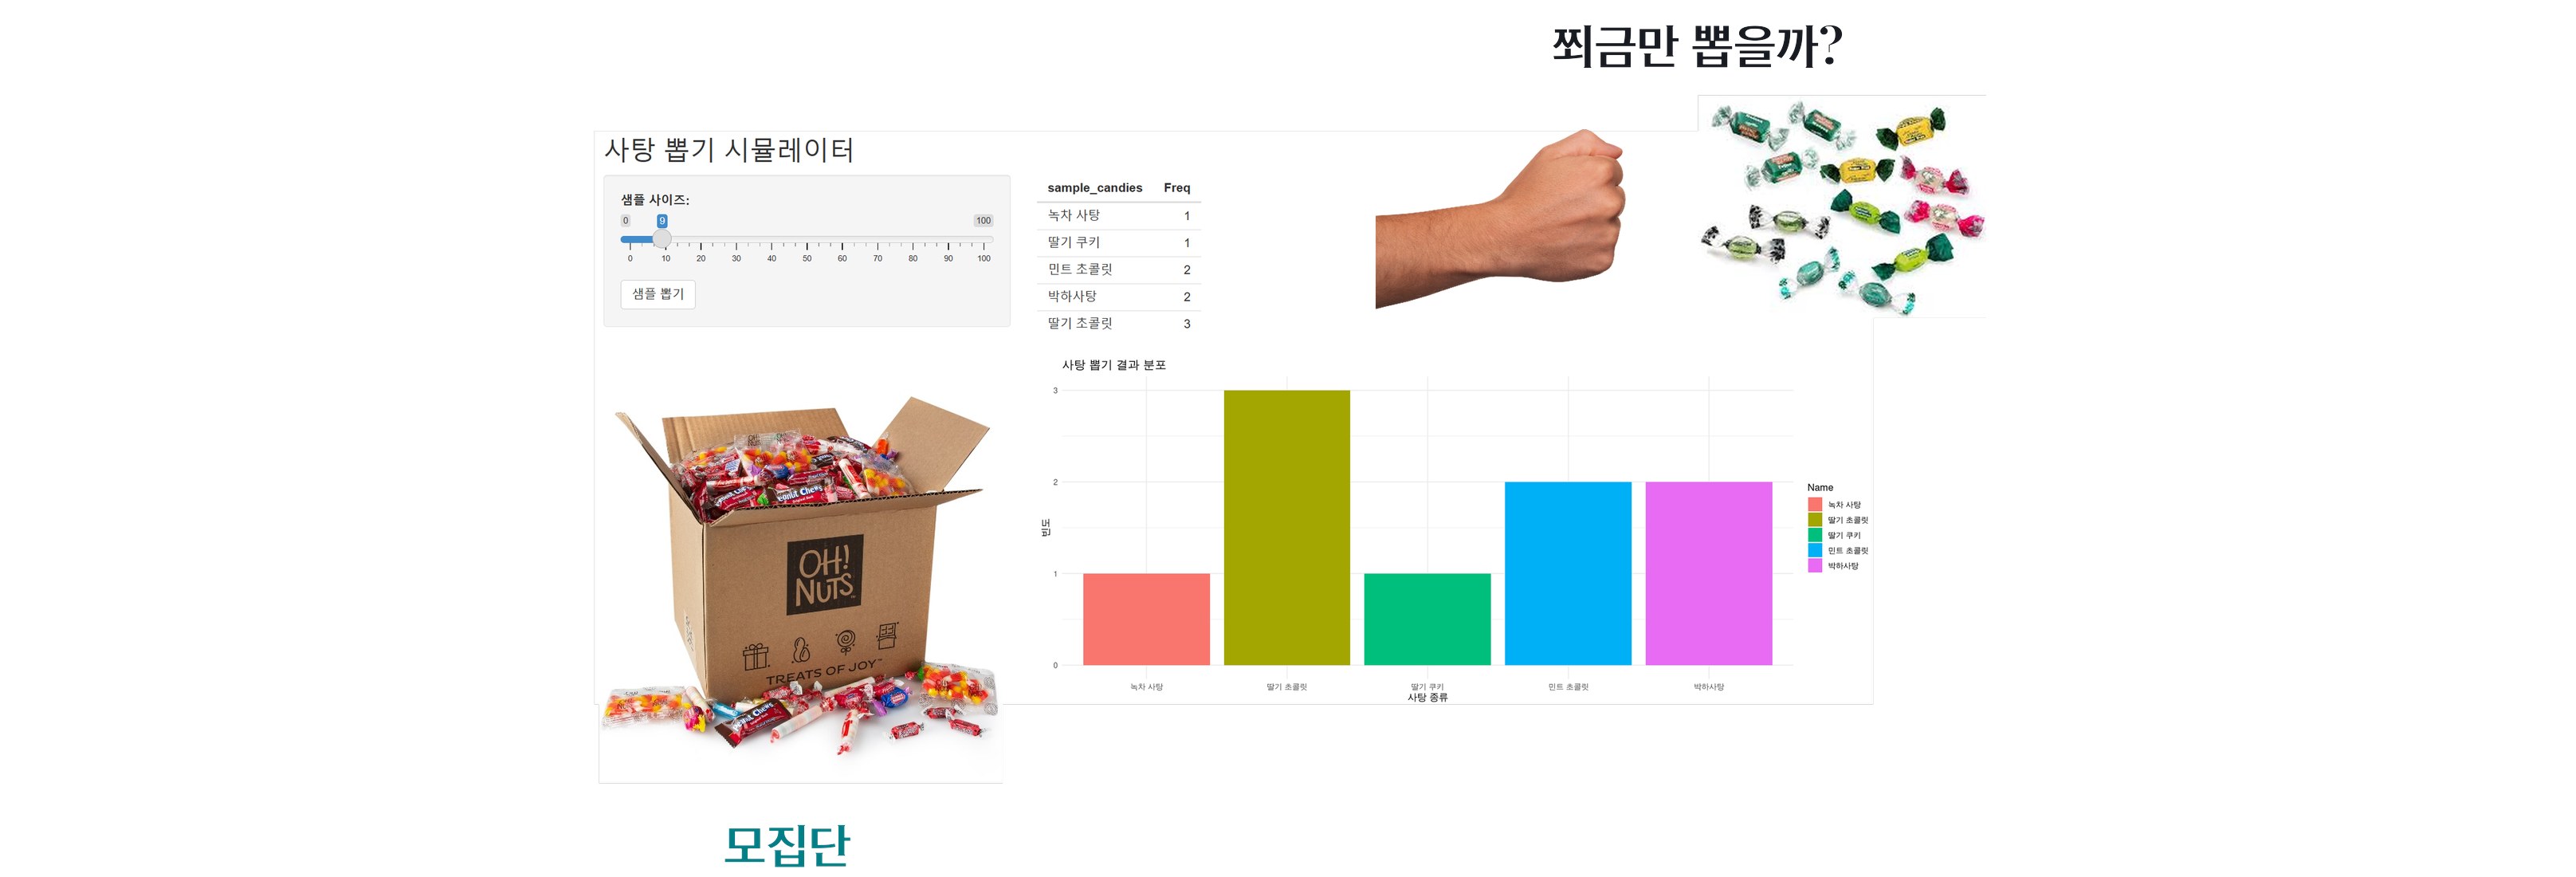
사탕 뽑기 시뮬레이터 화면 위에 오른쪽 ‘쬐금만 뽑을까?’ 주먹과 사탕 몇 개, 왼쪽 아래 사탕 상자(모집단) 사진이 겹쳐 있다. 사탕 뽑기 시뮬레이터 화면: 왼쪽 위에 뽑을 개수 슬라이더와 뽑힌 사탕 종류별 개수 표, 아래에 종류별 막대그래프
원본 화면의 보조 문구
10 / 77
기술통계학 · 4/8
11. 기술통계학
기술통계학(Descriptive Statistics)
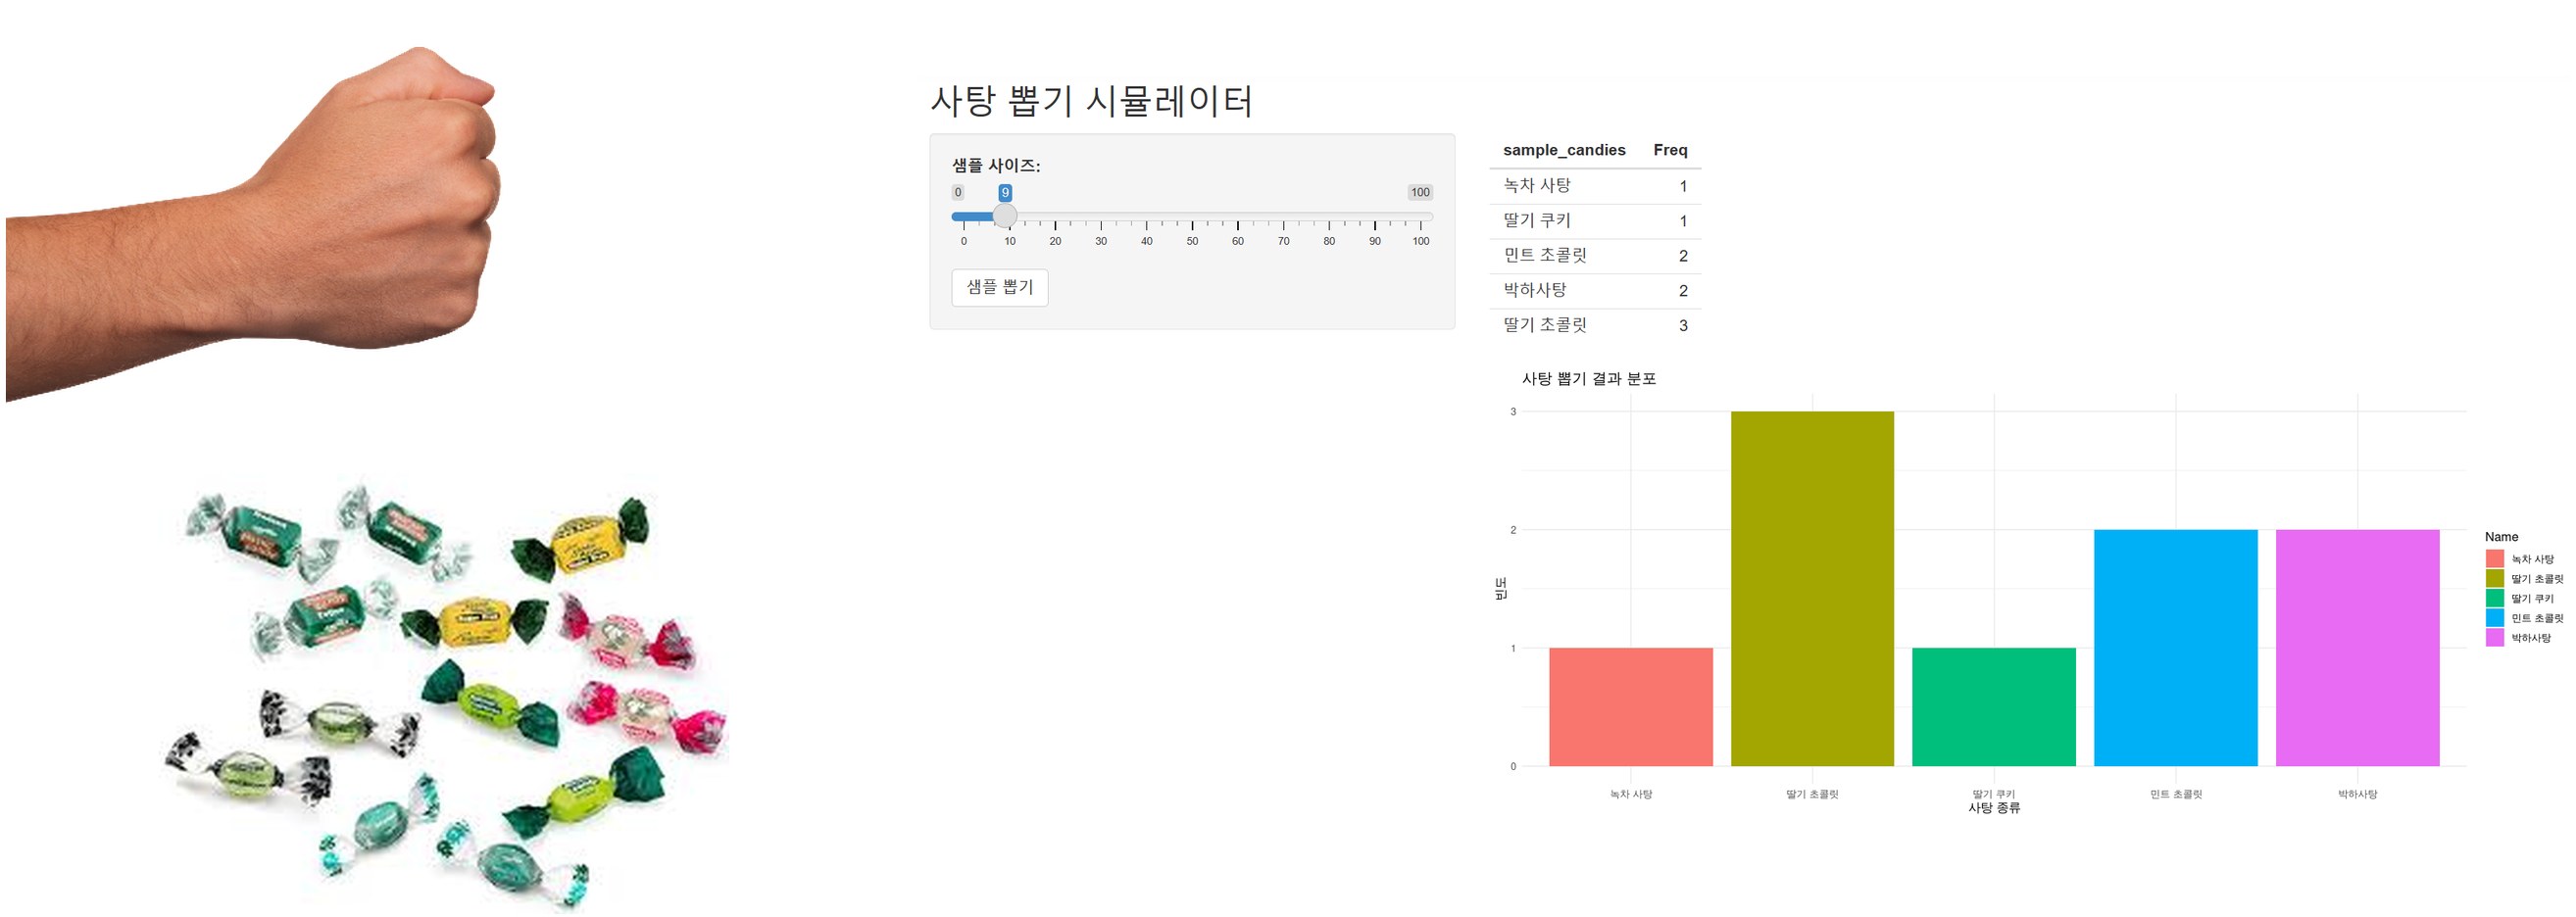
- 뽑힌 사탕 뭉치 내에서 각 사탕 종류별로 몇 개가 있는지 세어보고,
- 사탕 종류별 평균 갯수, 중앙값, 최빈값, 표준편차 등을 계산하고,
- 사탕 종류별 분포를 그래프로 나타내는 등,
- 뽑힌 사탕 뭉치(샘플) 내의 특성을 구체적으로 파악하는 작업
원본 화면의 보조 문구
11 / 77
기술통계학 · 5/8
12. 기술통계학의 종류와 해석 – 무엇으로 ‘한줄요약’ 할것인가
기술통계량 (자료의 특성을 수치로 표현)
집중화 경향 (Central Tendency)
- 최빈값 (mode)
- 중앙값 (median)
- 평균 (mean)
산포도 (Dispersion)
- 범위 (range)
- 분산 (variance)
- 표준편차 (standard deviation)
분포 (Distribution)
- 첨도 (kurtosis)
- 왜도 (skewness)
원본 화면의 보조 문구
12 / 77
기술통계학 · 6/8
13. 기술통계학의 종류와 해석
기술통계량 – 집중화 경향(Central Tendency)
수집한 데이터를 대표하는 값이 무엇인지 또는 어떤 값에 집중되어 있는지 다루는 통계량
| 최빈값 | 전체 자료들 중에서 가장 많은 빈도수를 나타낸 값 |
|---|---|
| 중앙값 | 전체 자료들을 가장 낮은 값에서 높은 값의 서열 순으로 나열했을 때 정확히 중간에 위치한 값 |
| 평균 | 전체 자료들을 합산한 후 이를 자료들의 개수로 나눈 값 |
원본 화면의 보조 문구
13 / 77
기술통계학 · 7/8
14. 기술통계학의 종류와 해석
평균
표 2-2 쇼핑몰 A, B의 월 매출액과 구매 수
| 쇼핑몰 | A | B |
|---|---|---|
| 월 매출액 | 300만 원 | 300만 원 |
| 월 구매 수 | 100회 | 100회 |
| 1회 구매당 평균 금액 | 3만 원 | 3만 원 |
표 2-3 3만 5천 원 무료배송 이후 쇼핑몰 A, B의 월 매출액과 구매 수
| 쇼핑몰 | A | B |
|---|---|---|
| 월 매출액 | 330만 원 | 600만 원 |
| 월 구매 수 | 110회 | 120회 |
| 1회 구매당 평균 금액 | 3만 원 | 5만 원 |
원본 화면의 보조 문구
14 / 77
기술통계학 · 8/8
15. 왜 R 인가?
R (Quantitative Finance)
- SPSS처럼 통계 분석을 수행하는데 특화된 소프트웨어
- SPSS는 매 달 매우 비싼 돈을 지불하지만 R은 오픈소스 (무료)다
- SPSS로 수행하는 거의 모든 최고 복잡한 통계를 다돌릴수 있다
- 유일한 단점: R은 코딩지식을 약간 알아야 한다
- 하지만 그 단점마저도 GPT를 활용하면 R 코딩을 거의 안배워도 되는 수준으로 난이도가 내려간다
원본 화면의 보조 문구
15 / 77
R과 기술통계량 · 1/22
16. R & R-Studio 설치
https://posit.co/download/rstudio-desktop/
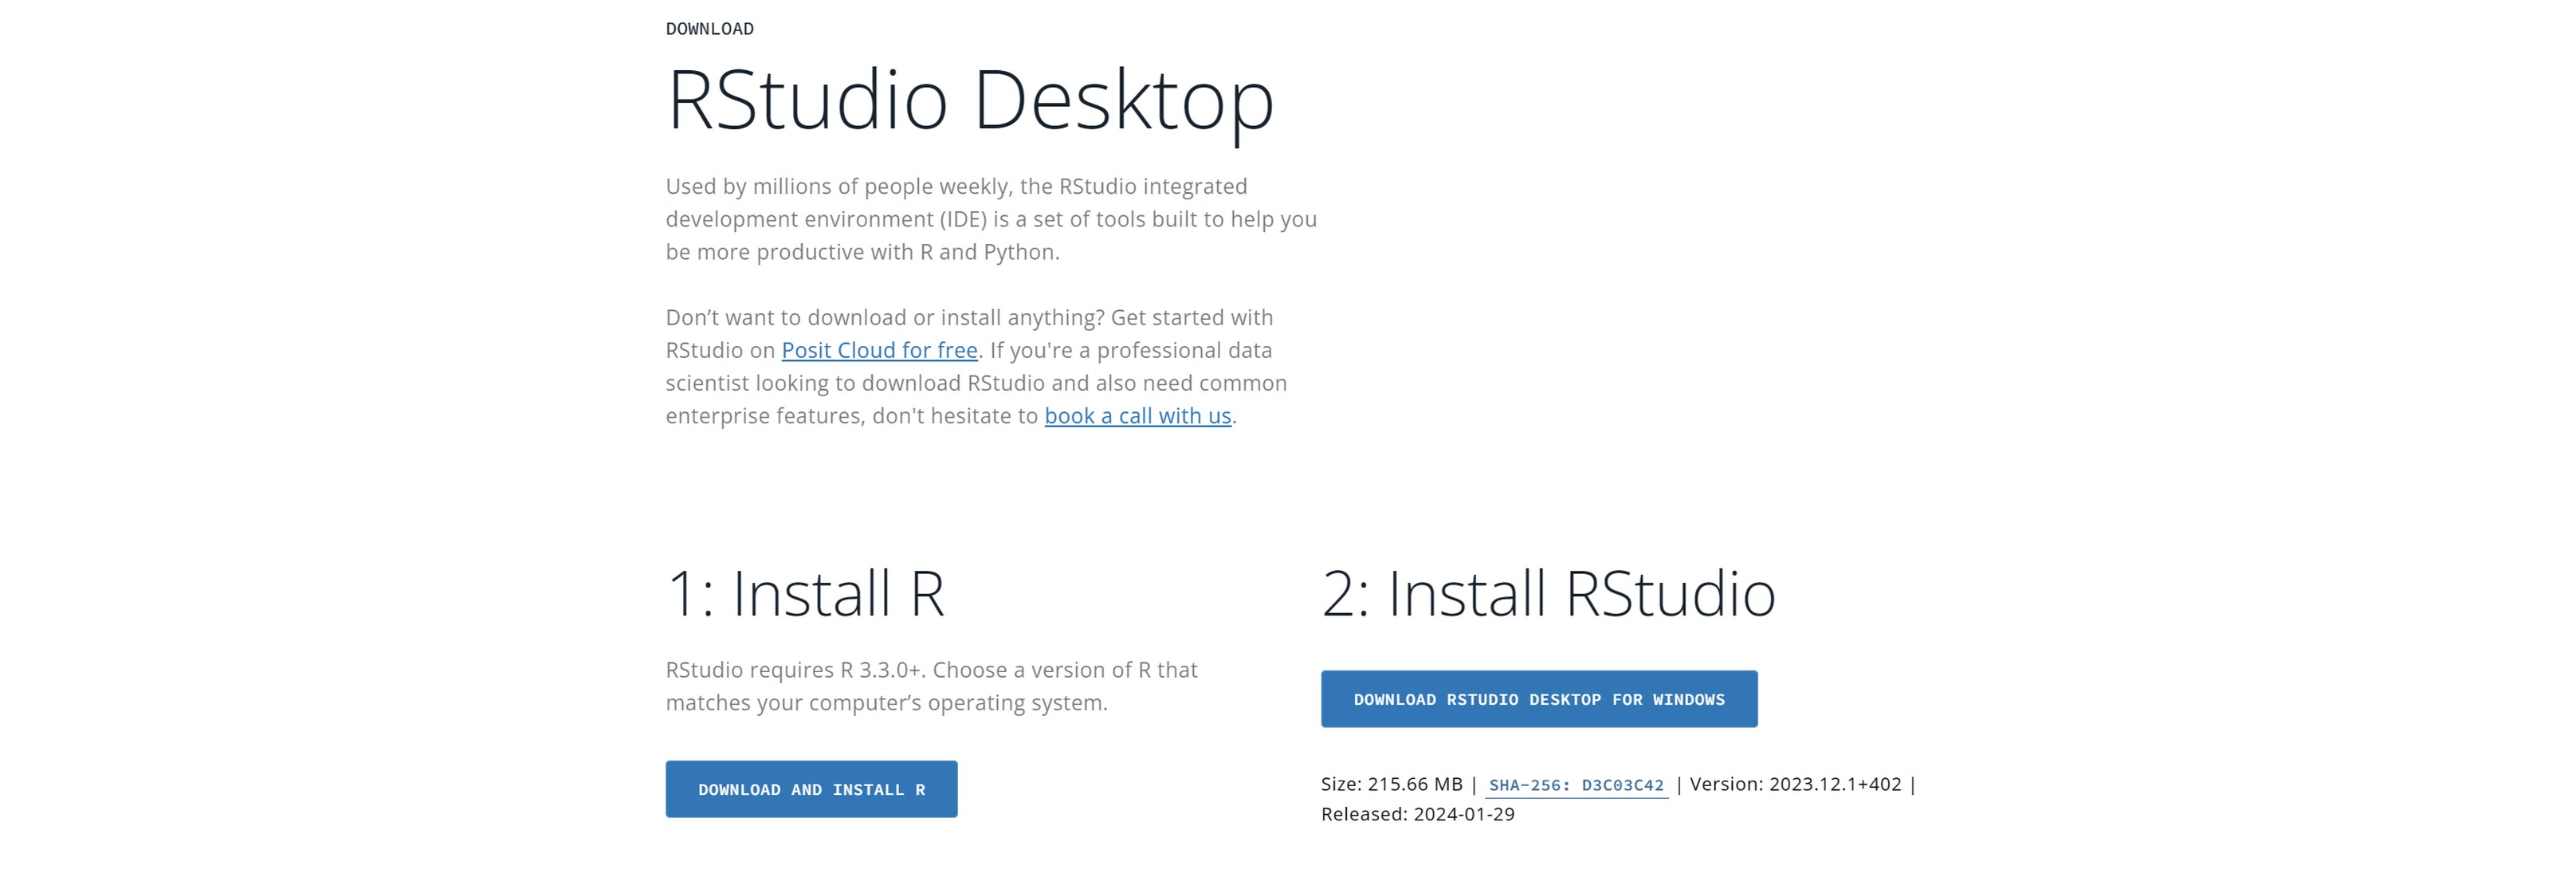
RStudio Desktop 내려받기 페이지: ‘1: Install R’, ‘2: Install RStudio’ 두 단계와 내려받기 버튼
원본 화면의 보조 문구
16 / 77
R과 기술통계량 · 2/22
17. R & R-Studio 설치
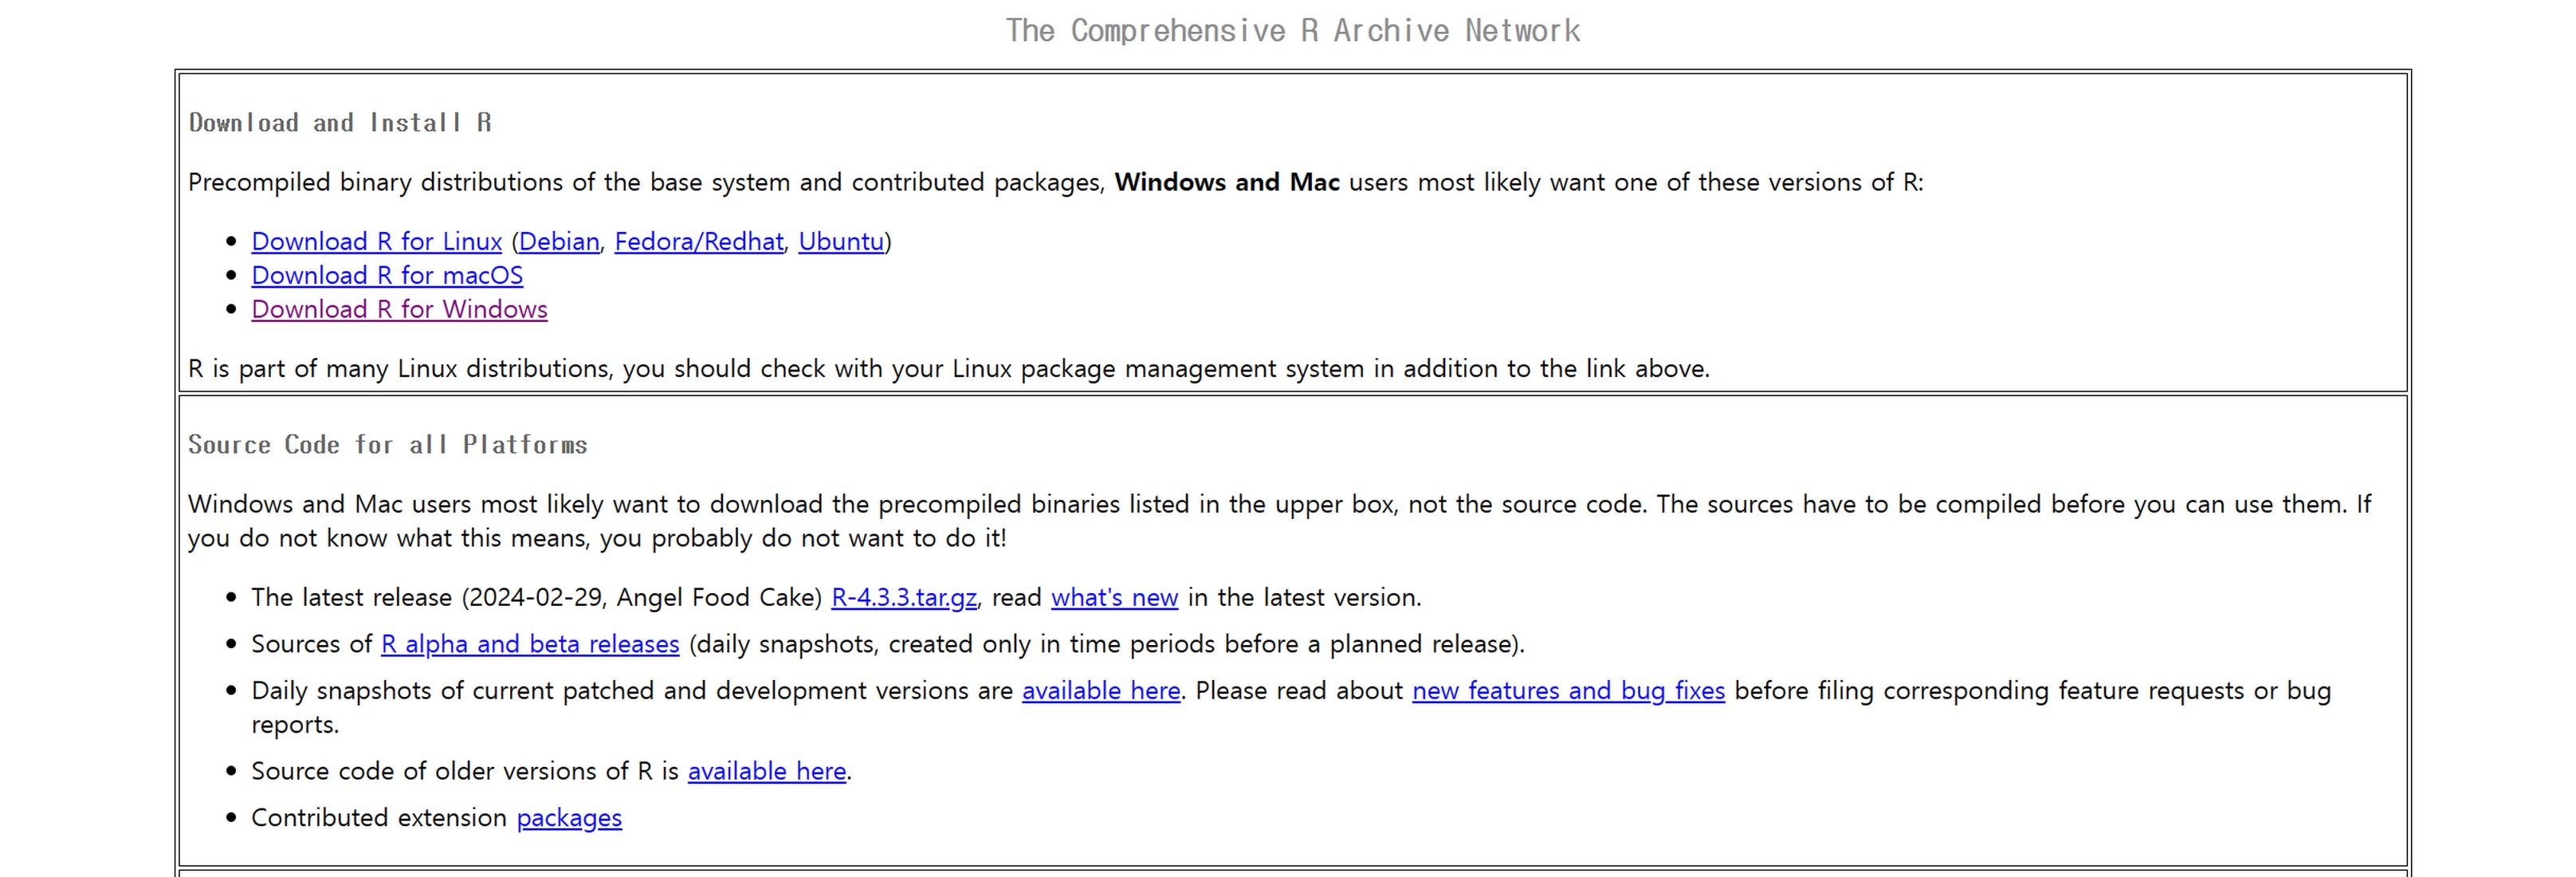
CRAN(The Comprehensive R Archive Network) 첫 화면: Linux·macOS·Windows용 R 내려받기 링크
원본 화면의 보조 문구
17 / 77
R과 기술통계량 · 3/22
18. R & R-Studio 설치
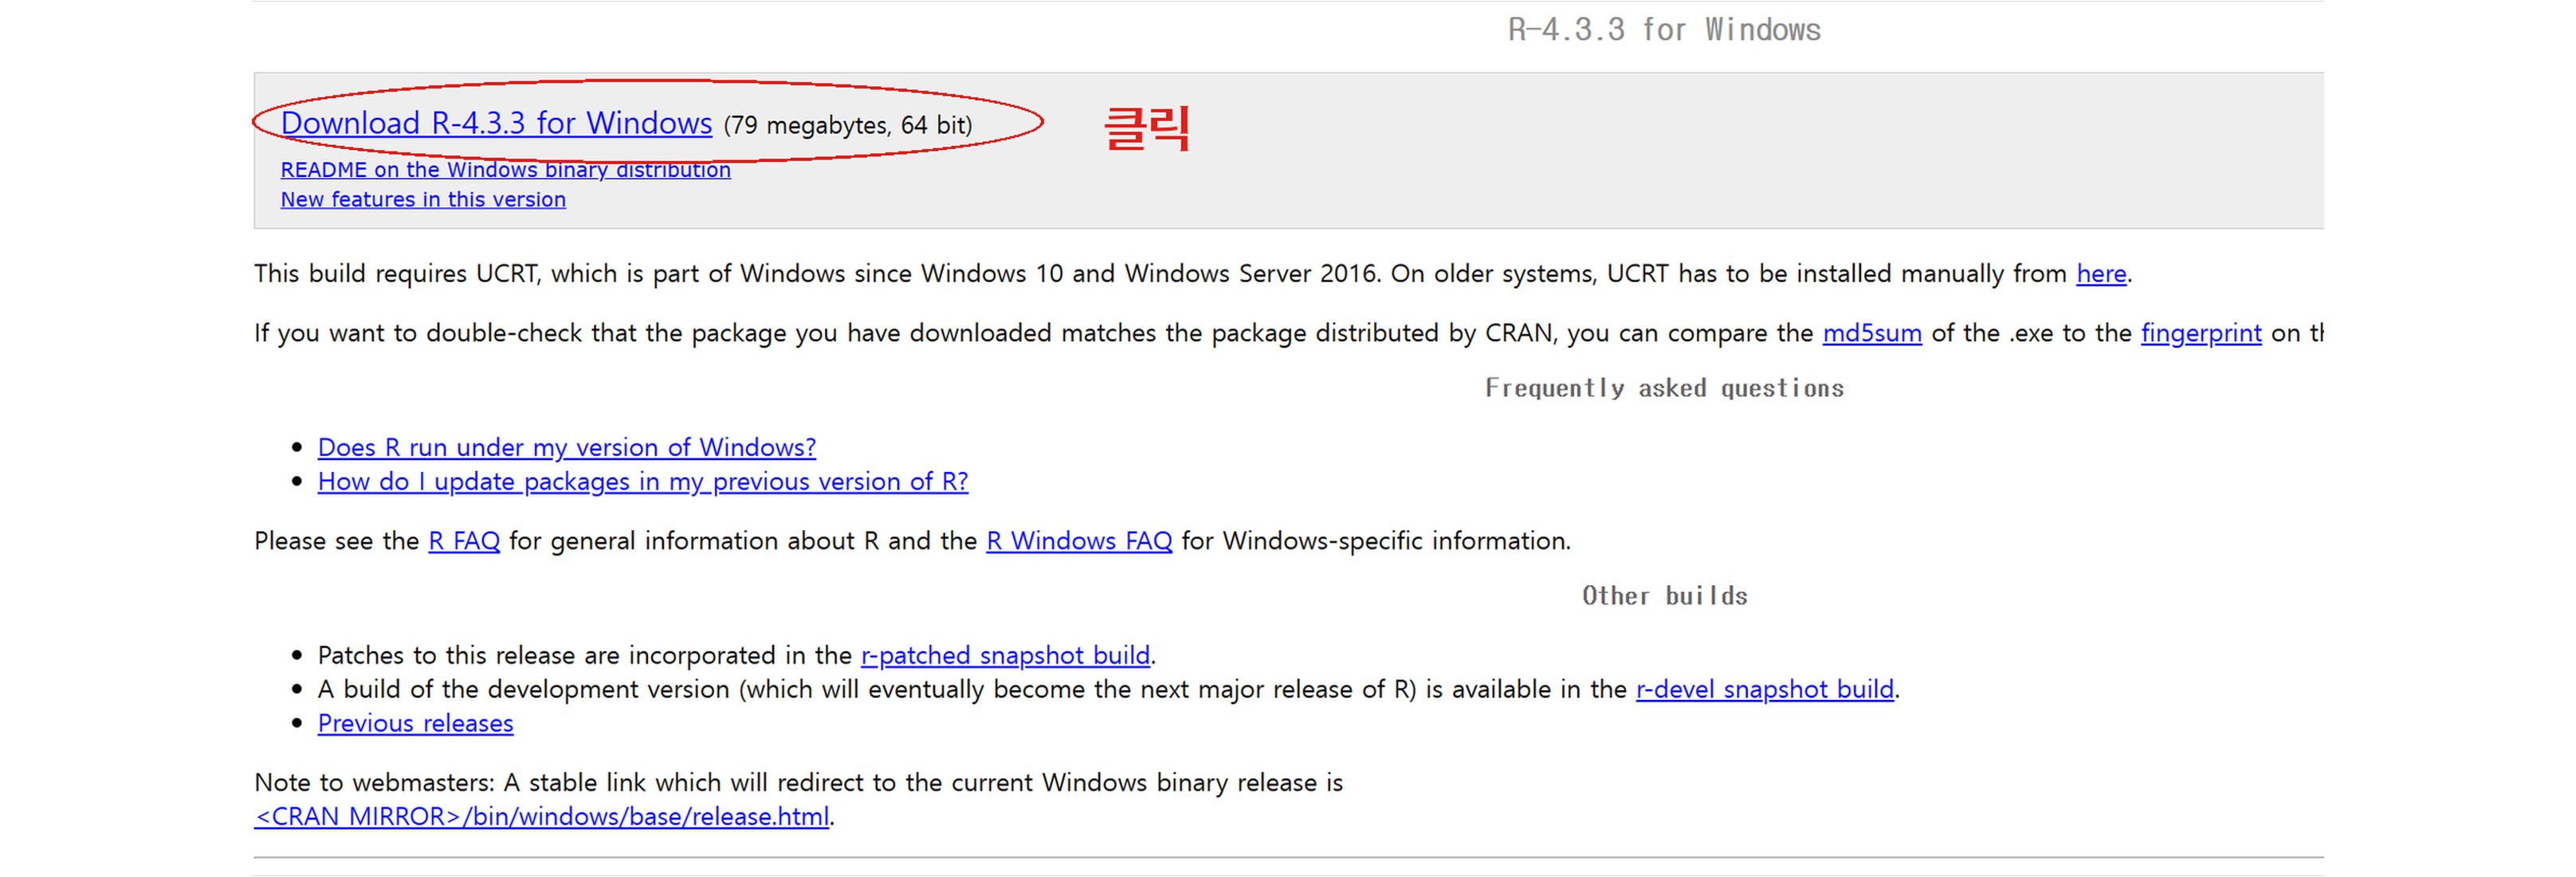
‘R-4.3.3 for Windows’ 페이지. 맨 위 ‘Download R-4.3.3 for Windows’ 링크에 빨간 원과 ‘클릭’ 표시
원본 화면의 보조 문구
18 / 77
R과 기술통계량 · 4/22
19. R & R-Studio 설치
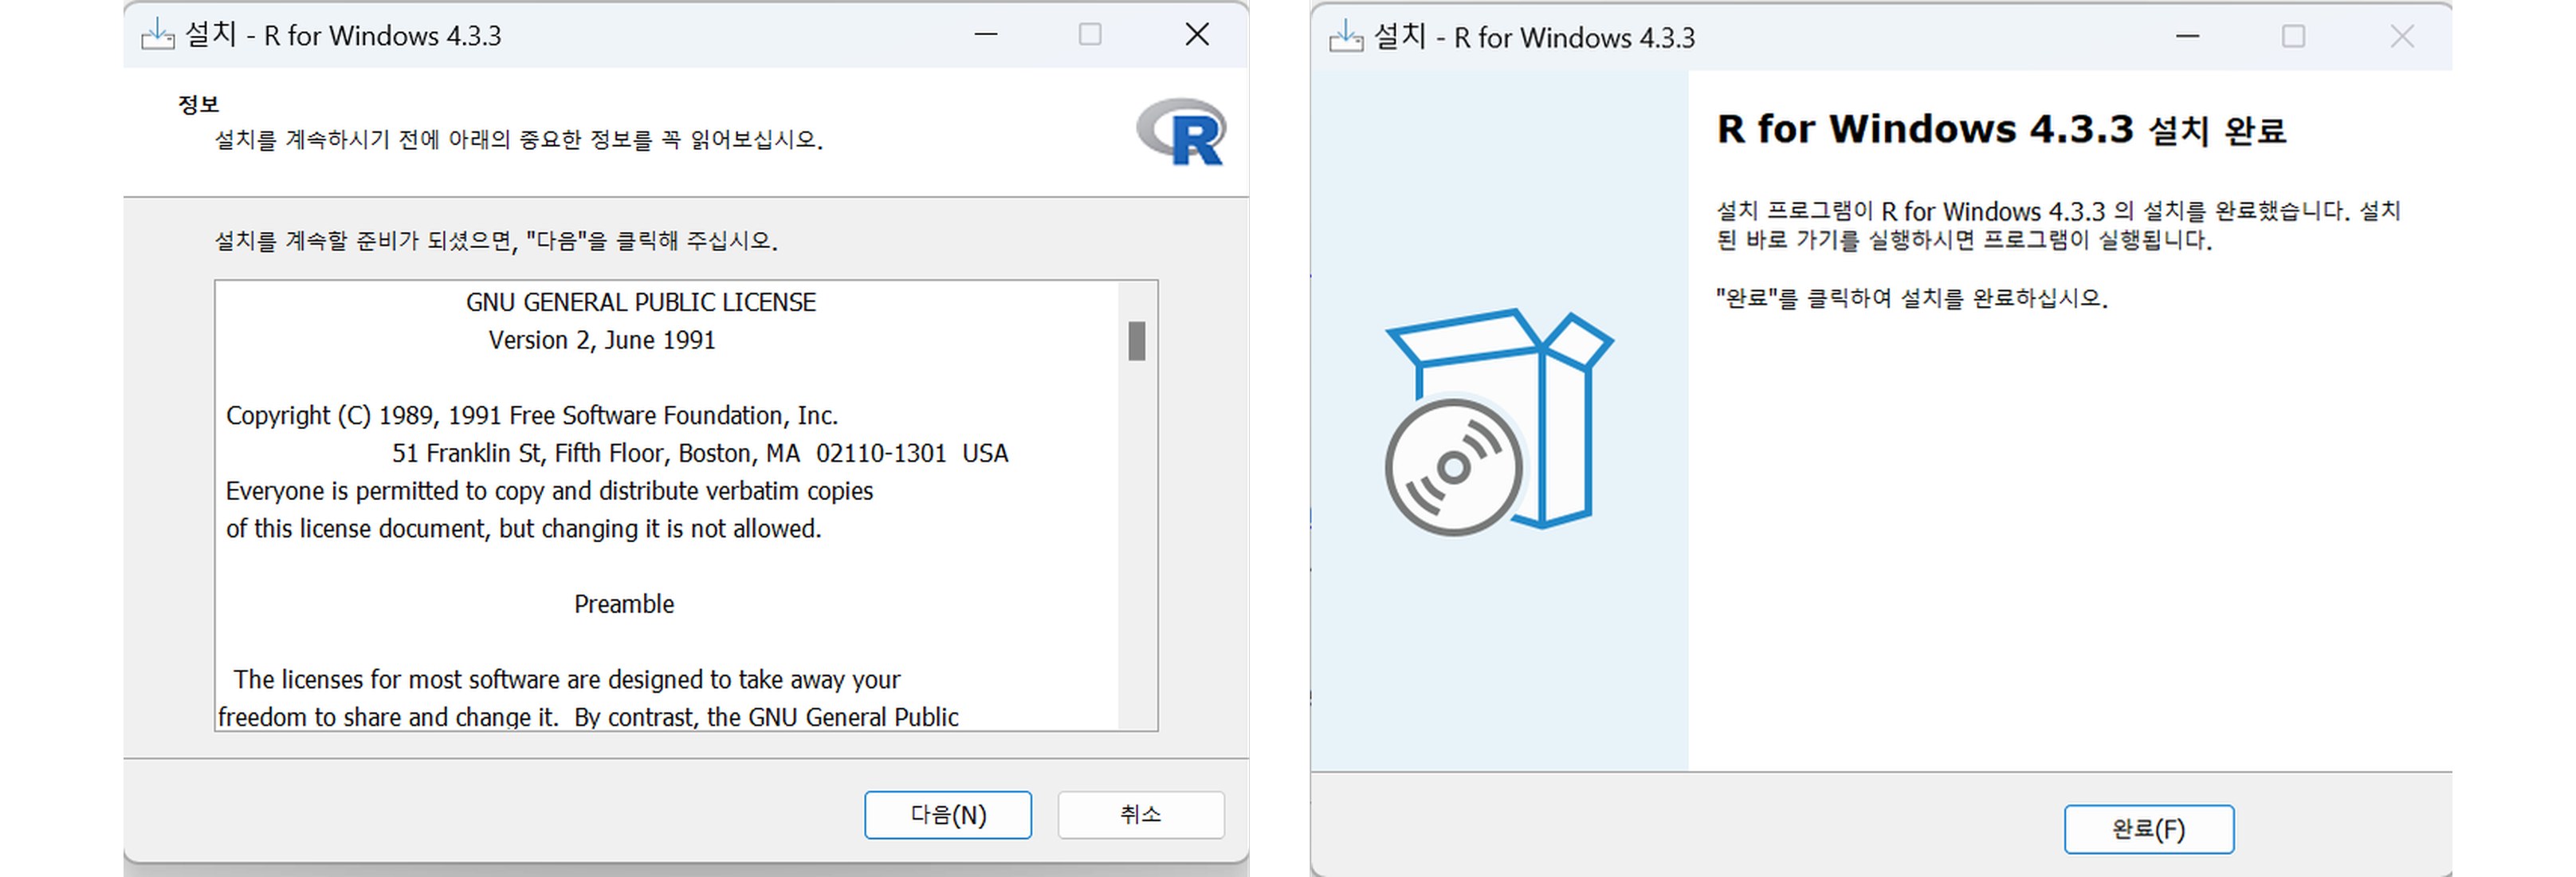
R for Windows 4.3.3 설치 화면 두 장: 왼쪽은 GNU General Public License 동의 단계, 오른쪽은 설치 완료 화면
원본 화면의 보조 문구
19 / 77
R과 기술통계량 · 5/22
20. R & R-Studio 설치
https://posit.co/download/rstudio-desktop/
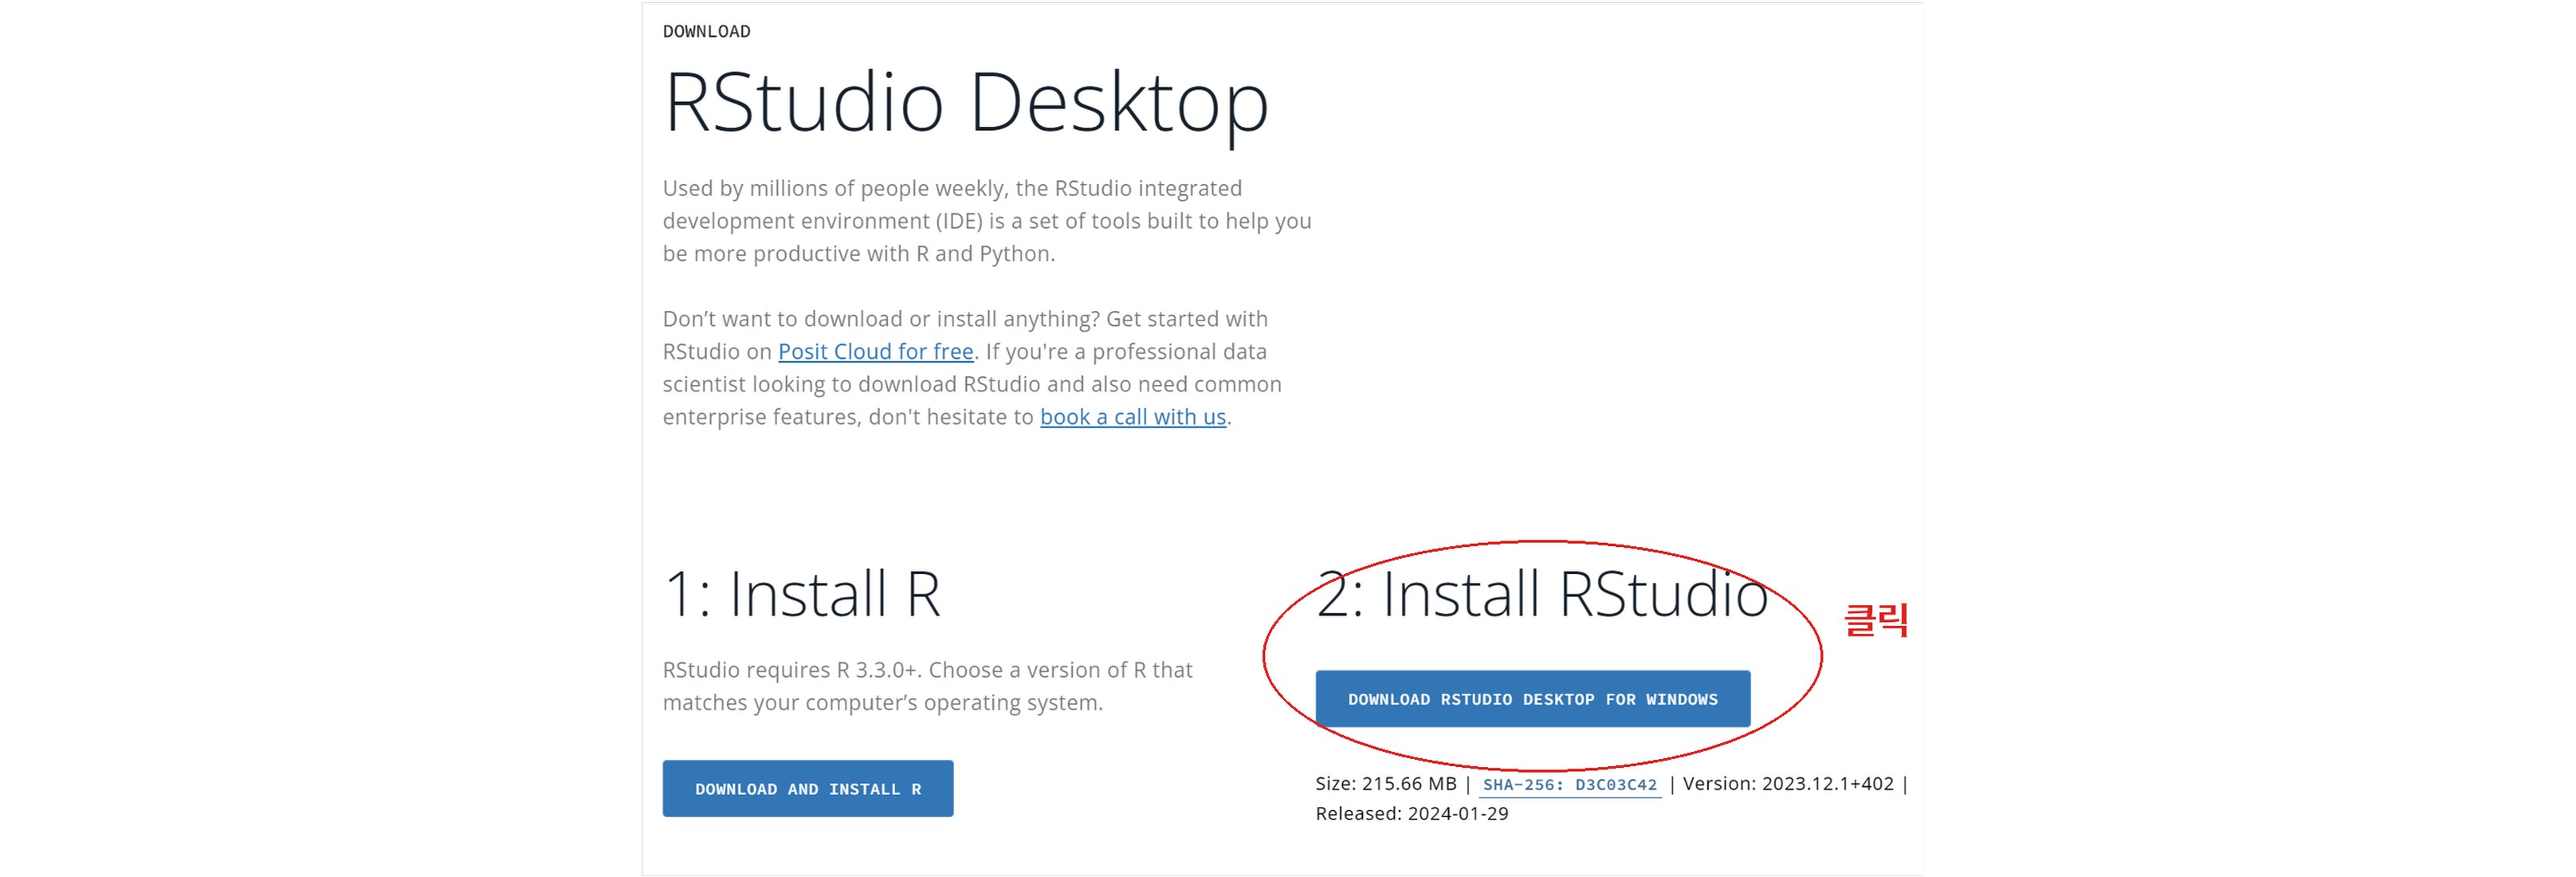
RStudio Desktop 내려받기 페이지. ‘2: Install RStudio’ 버튼에 빨간 원과 ‘클릭’ 표시
원본 화면의 보조 문구
20 / 77
R과 기술통계량 · 6/22
21. R & R-Studio 설치
https://posit.co/download/rstudio-desktop/
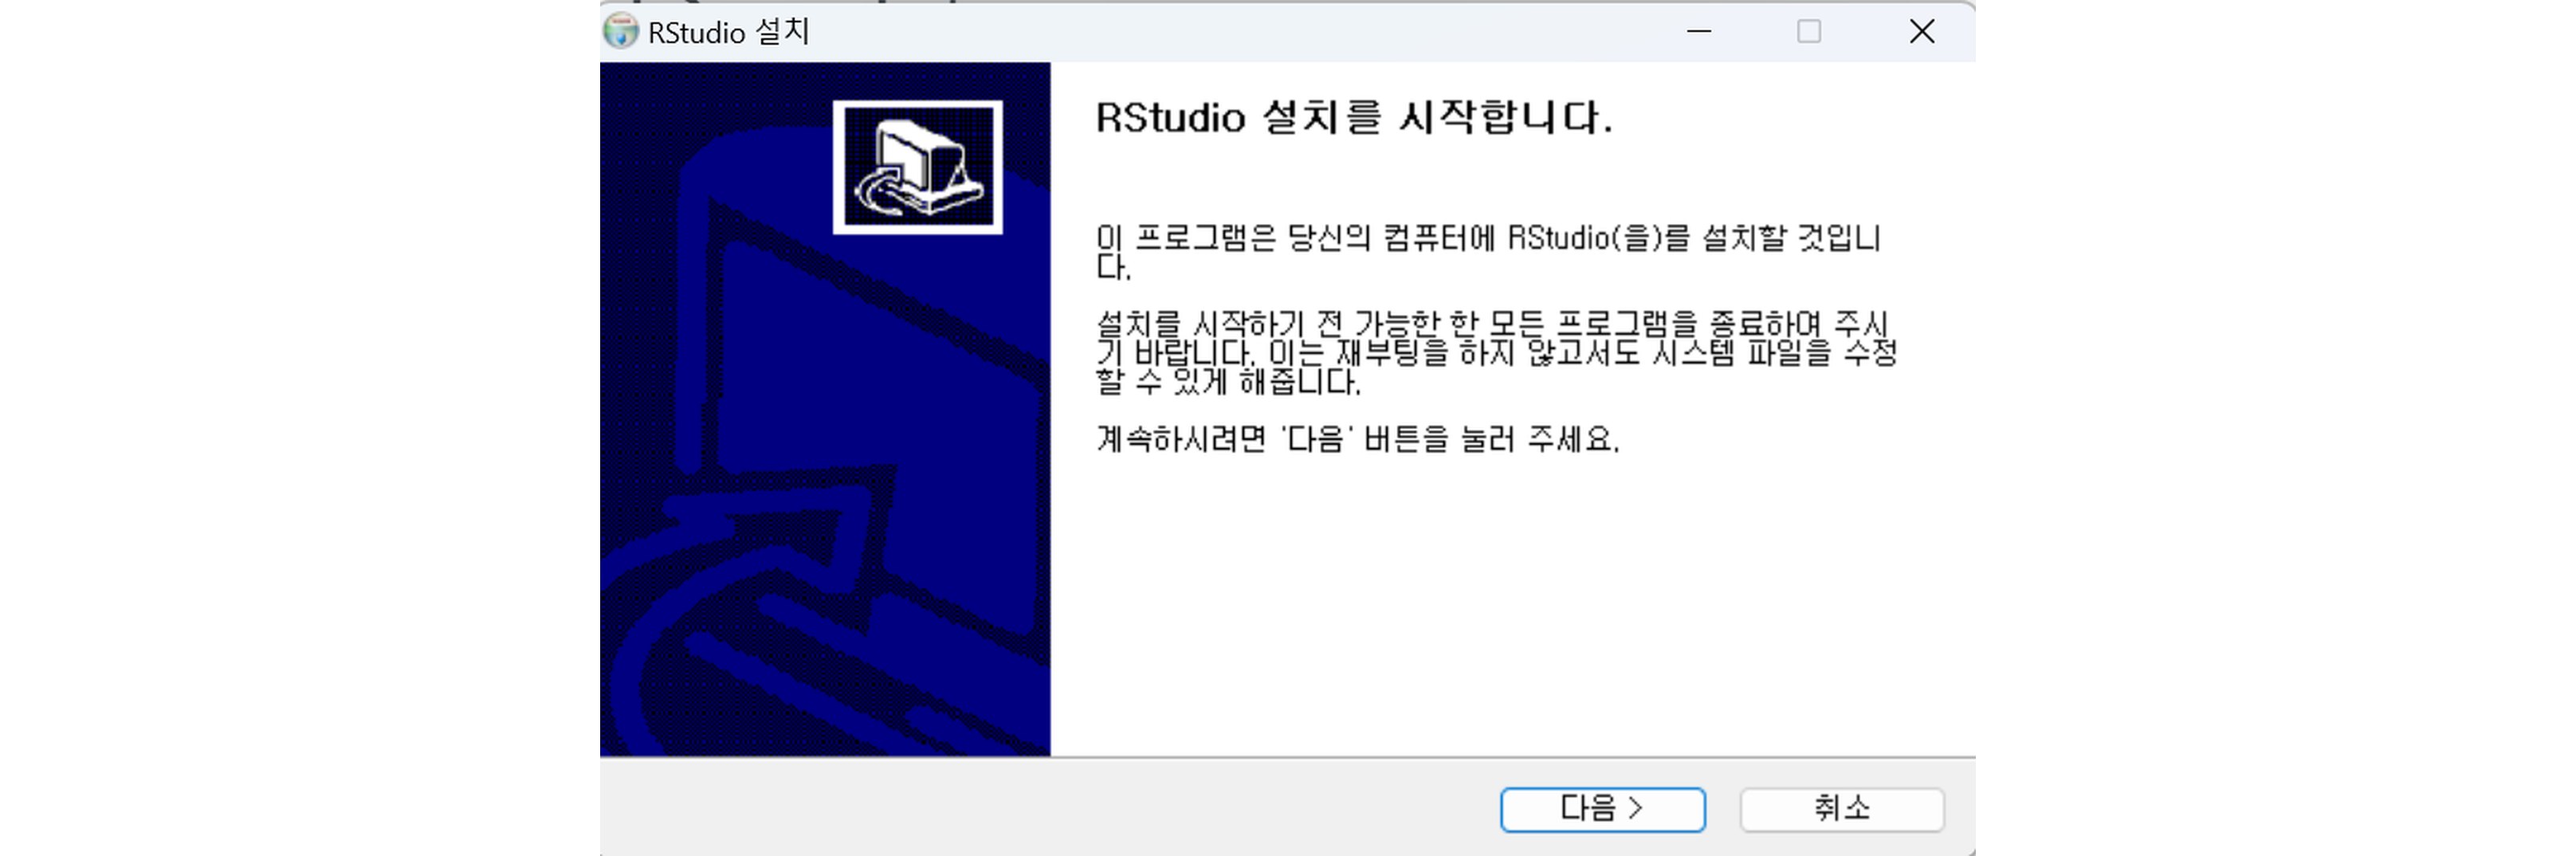
‘RStudio 설치’ 시작 화면: ‘RStudio 설치를 시작합니다’ 안내와 다음 버튼
원본 화면의 보조 문구
21 / 77
R과 기술통계량 · 7/22
22. R-Studio 실행
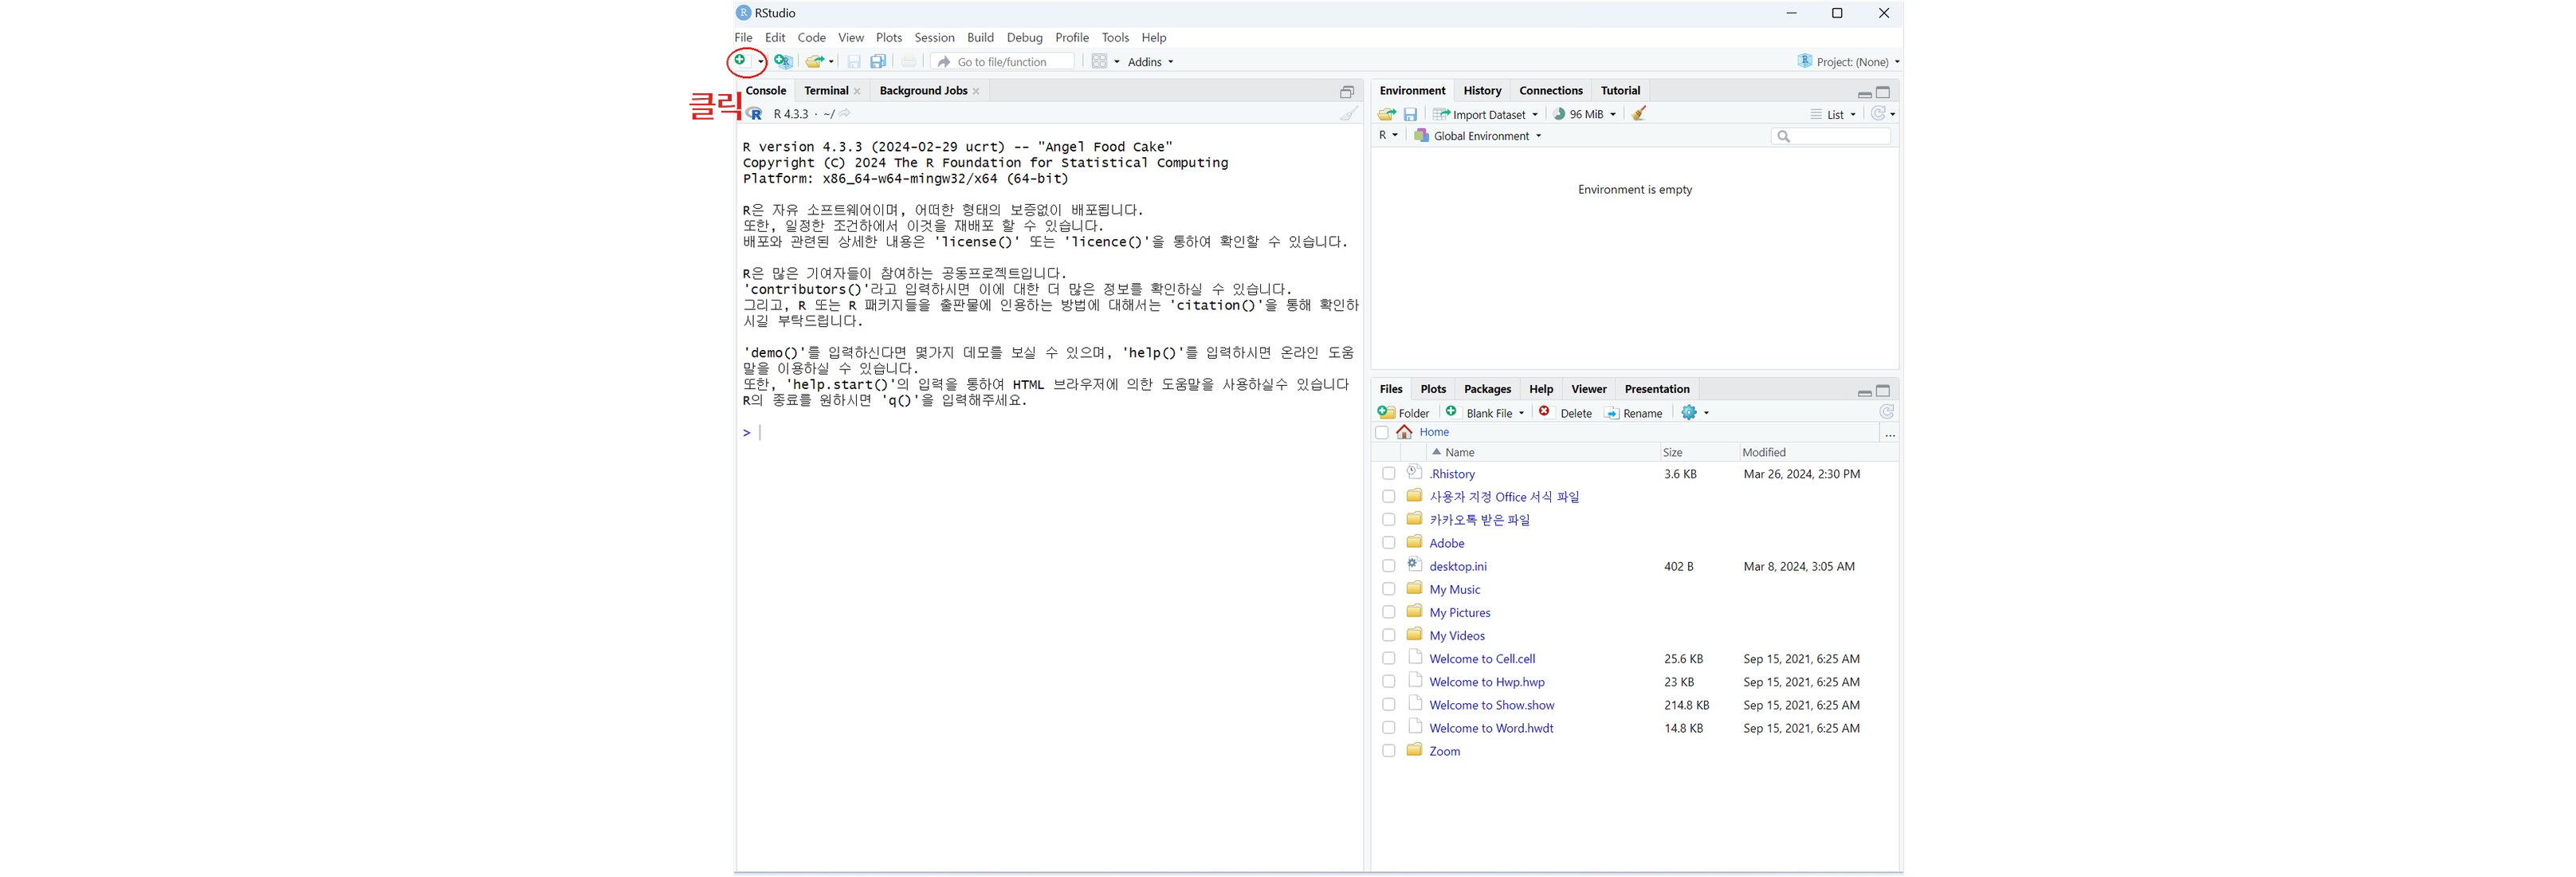
RStudio 첫 실행 화면. 왼쪽 위 새 파일 버튼에 빨간 원과 ‘클릭’ 표시
원본 화면의 보조 문구
22 / 77
R과 기술통계량 · 8/22
23. R-Studio 실행
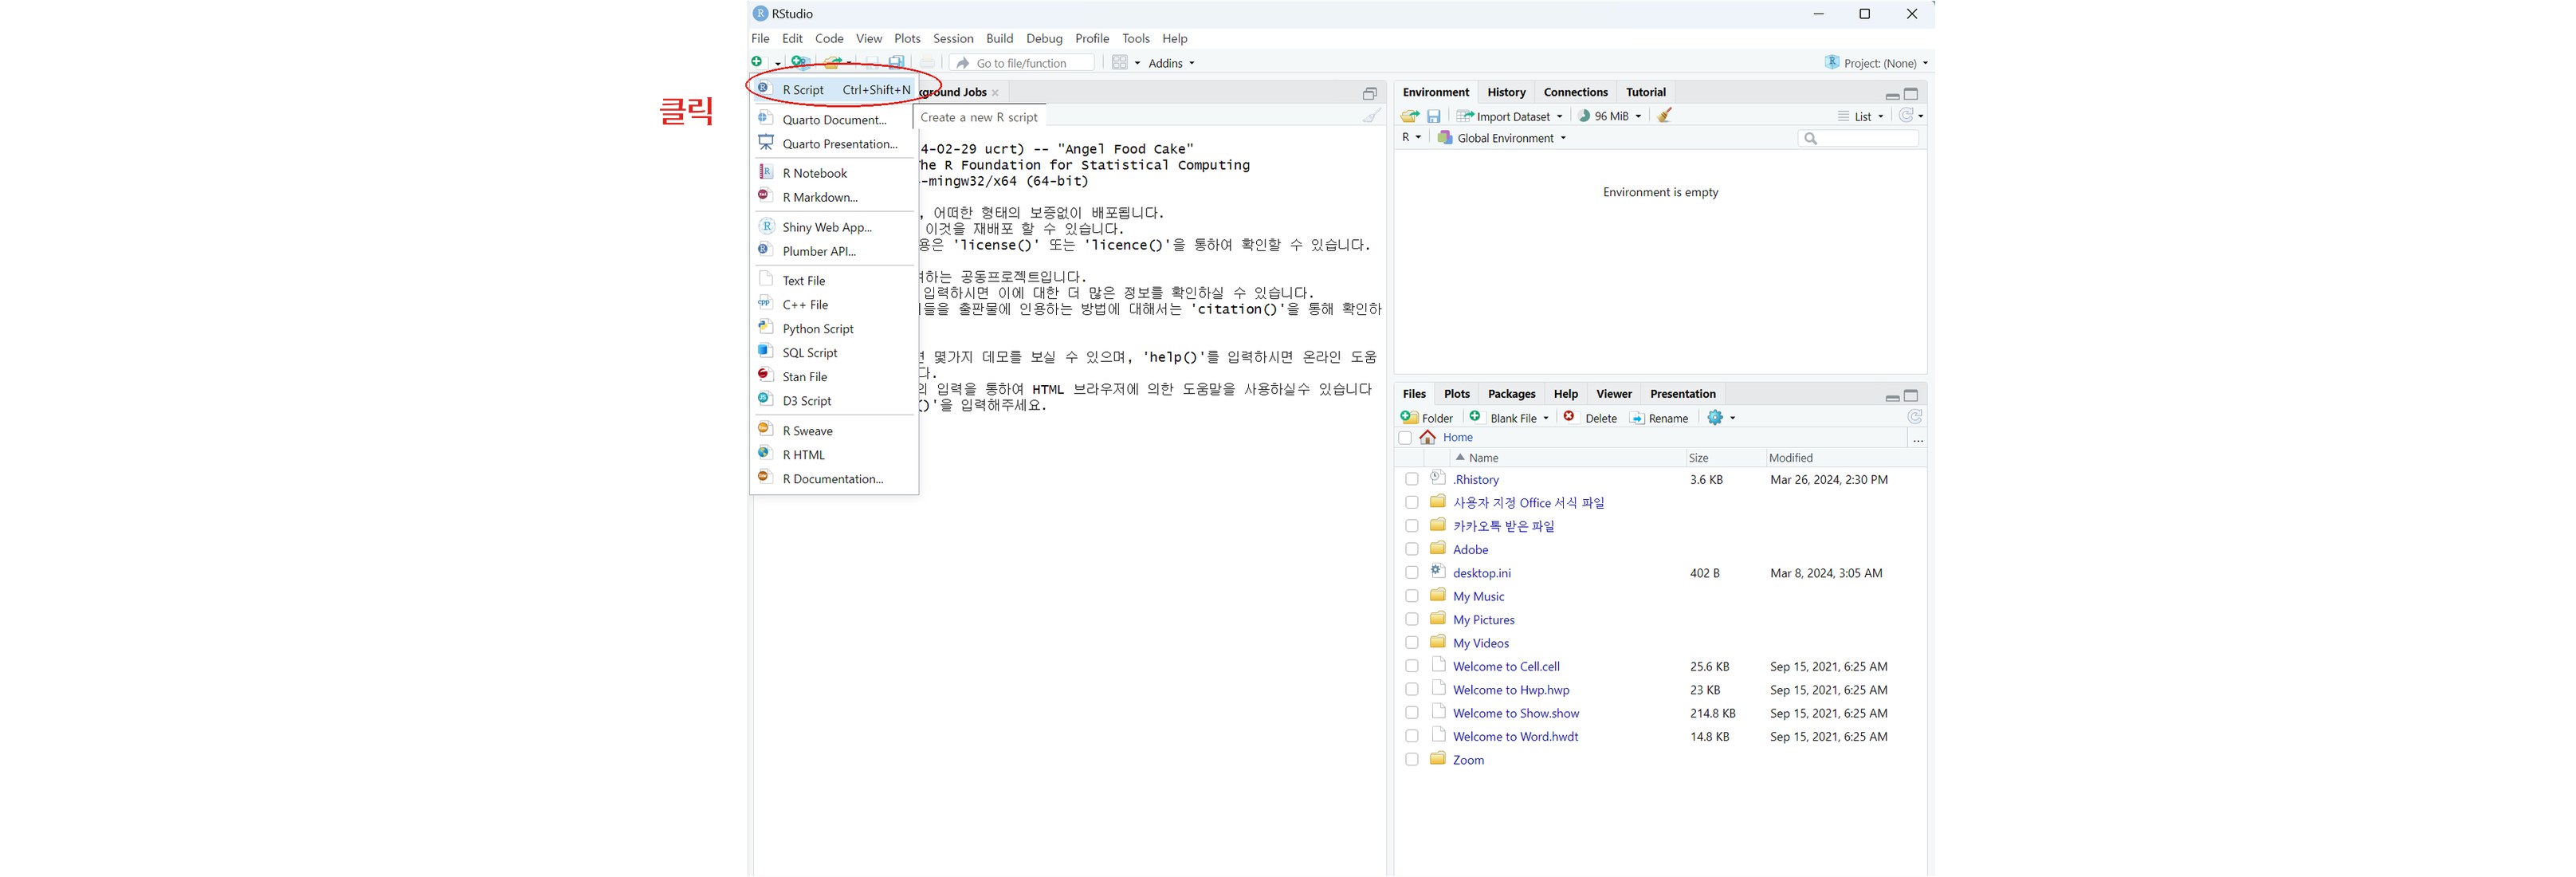
RStudio 새 파일 메뉴가 열린 화면. 맨 위 ‘R Script’ 항목에 빨간 원과 ‘클릭’ 표시
원본 화면의 보조 문구
23 / 77
R과 기술통계량 · 9/22
24. R-Studio 실행
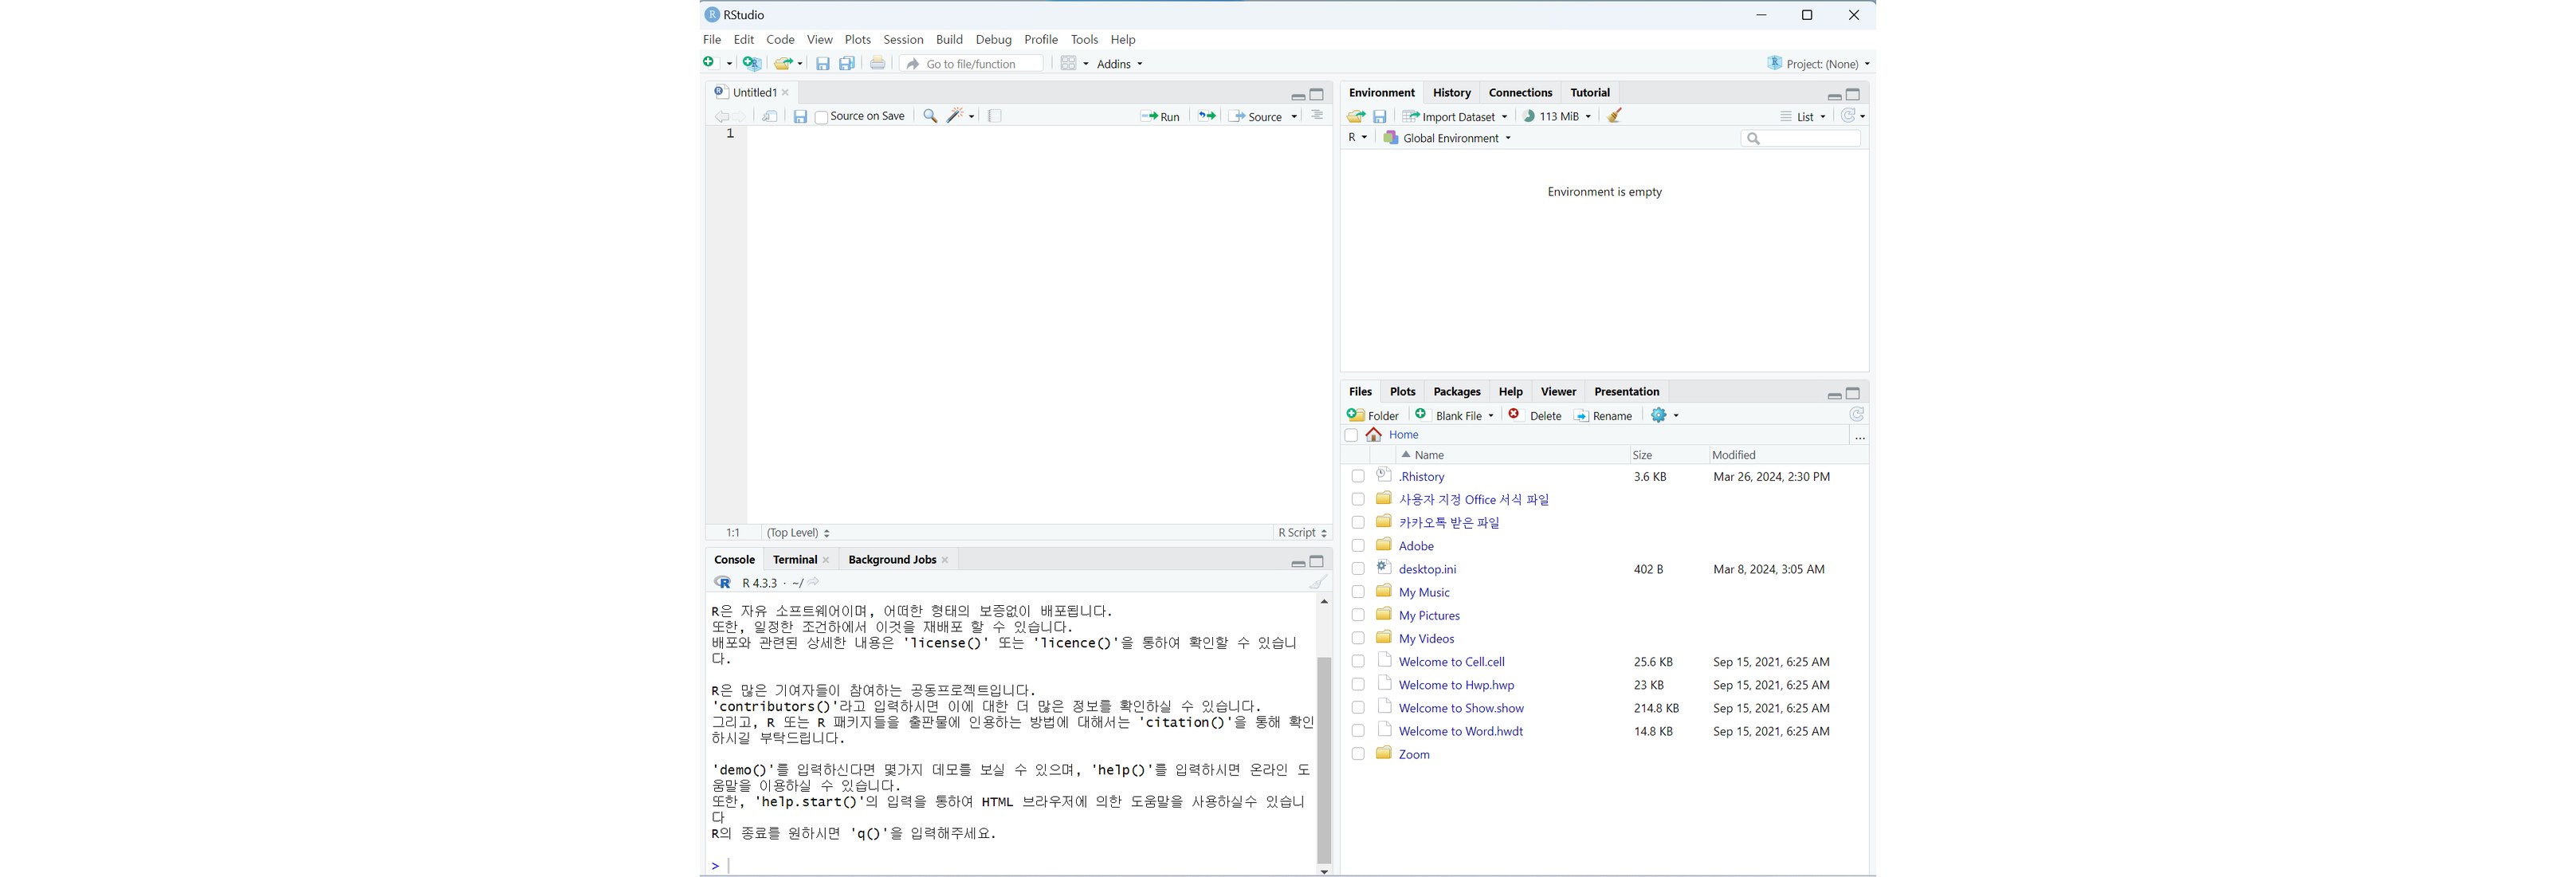
RStudio에 빈 R 스크립트 창이 열린 화면
원본 화면의 보조 문구
24 / 77
R과 기술통계량 · 10/22
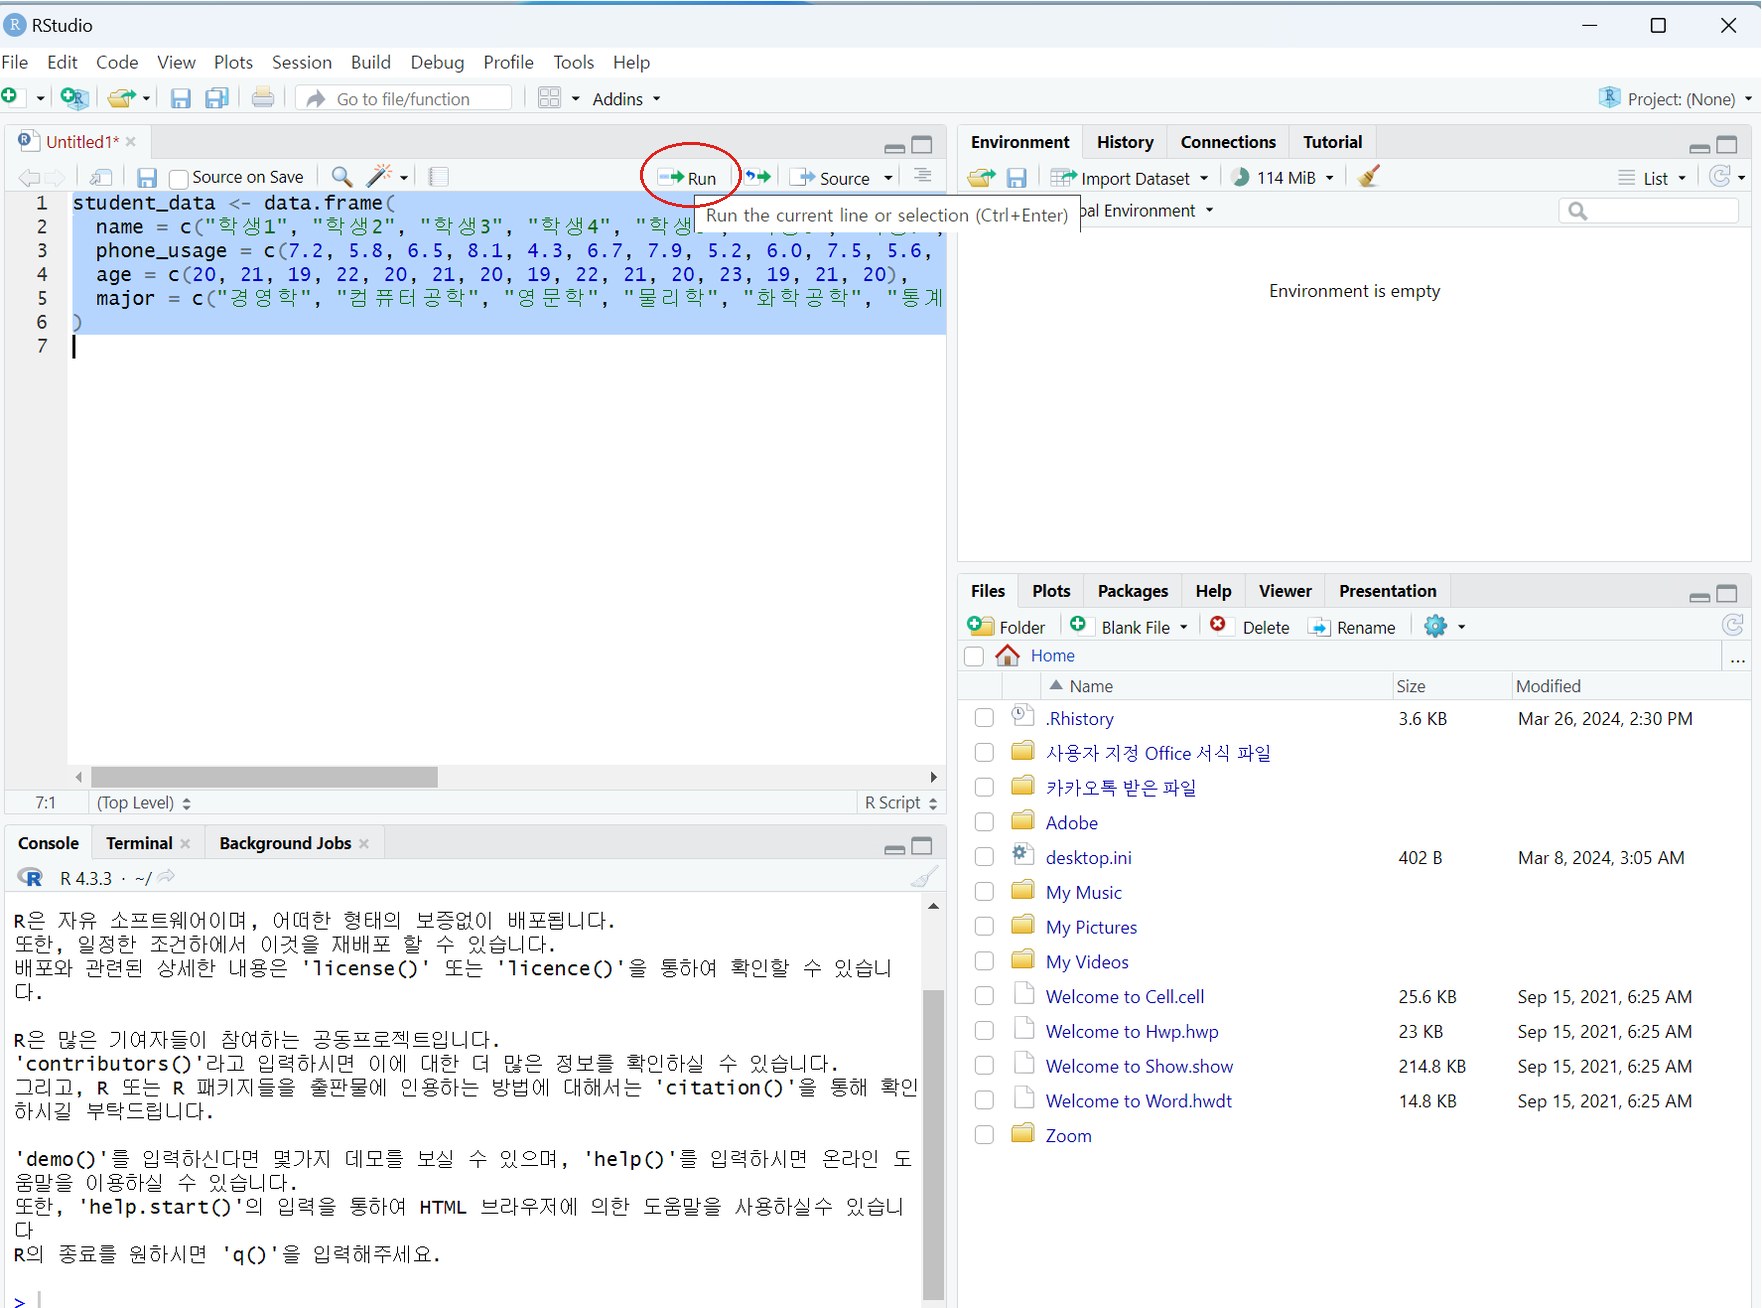
25. R-Studio 실행 : 다음의 코드를 그대로 Ctrl+C / Ctrl+V
student_data <- data.frame(
  name = c("학생1", "학생2", "학생3", "학생4", "학생5", "학생6", "학생7", "학생8",
           "학생9", "학생10", "학생11", "학생12", "학생13", "학생14", "학생15"),
  phone_usage = c(7.2, 5.8, 6.5, 8.1, 4.3, 6.7, 7.9, 5.2, 6.0, 7.5, 5.6, 6.3, 8.5, 5.0, 24.0),
  age = c(20, 21, 19, 22, 20, 21, 20, 19, 22, 21, 20, 23, 19, 21, 20),
  major = c("경영학", "컴퓨터공학", "영문학", "물리학", "화학공학", "통계학", "경제학",
            "정치외교학", "생명과학", "전자공학", "국문학", "수학", "건축공학", "심리학", "사회학"))
원본 화면의 보조 문구
25 / 77
R과 기술통계량 · 11/22
26. R-Studio 실행 : 다음의 코드를 그대로 Ctrl+C / Ctrl+V
전부 선택하고 Run 클릭
또는 Ctrl+Enter
원본 화면의 보조 문구
26 / 77
R과 기술통계량 · 12/22
27. 기술통계량 예제 자료
| name | phone_usage | age | major |
|---|---|---|---|
| 학생1 | 7.2 | 20 | 경영학 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 |
| 학생3 | 6.5 | 19 | 영문학 |
| 학생4 | 8.1 | 22 | 물리학 |
| 학생5 | 4.3 | 20 | 화학공학 |
| 학생6 | 6.7 | 21 | 통계학 |
| 학생7 | 7.9 | 20 | 경제학 |
| 학생8 | 5.2 | 19 | 정치외교학 |
| name | phone_usage | age | major |
|---|---|---|---|
| 학생9 | 6.0 | 22 | 생명과학 |
| 학생10 | 7.5 | 21 | 전자공학 |
| 학생11 | 5.6 | 20 | 국문학 |
| 학생12 | 6.3 | 23 | 수학 |
| 학생13 | 8.5 | 19 | 건축공학 |
| 학생14 | 5.0 | 21 | 심리학 |
| 학생15 | 24.0 | 20 | 사회학 |
원본 화면의 보조 문구
27 / 77
R과 기술통계량 · 13/22
28. 기술통계학의 종류와 해석 - 최빈값
기술통계량 – 집중화 경향(Central Tendency)
수집한 데이터를 대표하는 값이 무엇인지 또는 어떤 값에 집중되어 있는지 다루는 통계량
| 최빈값 | 전체 자료들 중에서 가장 많은 빈도수를 나타낸 값 |
|---|---|
| 중앙값 | 전체 자료들을 가장 낮은 값에서 높은 값의 서열 순으로 나열했을 때 정확히 중간에 위치한 값 |
| 평균 | 전체 자료들을 합산한 후 이를 자료들의 개수로 나눈 값 |
원본 화면의 보조 문구
28 / 77
R과 기술통계량 · 14/22
29. AI & R Exercise - 최빈값
프롬프트:
- “이 데이터셋에서 phone_usage의 최빈값을 구해줘”
- “이 데이터셋에서 phone_usage의 최빈값을 구하기 위해 해당 변인 내의 각각의 값을 카운트해줘”
R 코드로 확인:
freq <- table(student_data$phone_usage)
maxfreq <- max(freq)
which(freq == maxfreq)
table(student_data$phone_usage)
눈으로 직접 확인
R 실행 결과
> which(freq == maxfreq)
4.3   5 5.2 5.6 5.8   6 6.3 6.5 6.7 7.2 7.5 7.9 8.1
  1   2   3   4   5   6   7   8   9  10  11  12  13
8.5  24
 14  15
> table(student_data$phone_usage)

4.3   5 5.2 5.6 5.8   6 6.3 6.5 6.7 7.2 7.5 7.9 8.1
  1   1   1   1   1   1   1   1   1   1   1   1   1
8.5  24
  1   1
원본 화면의 보조 문구
29 / 77
R과 기술통계량 · 15/22
30. 기술통계량 예제 자료 – 최빈값 정답
| name | phone_usage | age | major |
|---|---|---|---|
| 학생1 | 7.2 | 20 | 경영학 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 |
| 학생3 | 6.5 | 19 | 영문학 |
| 학생4 | 8.1 | 22 | 물리학 |
| 학생5 | 4.3 | 20 | 화학공학 |
| 학생6 | 6.7 | 21 | 통계학 |
| 학생7 | 7.9 | 20 | 경제학 |
| 학생8 | 5.2 | 19 | 정치외교학 |
| name | phone_usage | age | major |
|---|---|---|---|
| 학생9 | 6.0 | 22 | 생명과학 |
| 학생10 | 7.5 | 21 | 전자공학 |
| 학생11 | 5.6 | 20 | 국문학 |
| 학생12 | 6.3 | 23 | 수학 |
| 학생13 | 8.5 | 19 | 건축공학 |
| 학생14 | 5.0 | 21 | 심리학 |
| 학생15 | 24.0 | 20 | 사회학 |
모든 값이 전부 1번씩만 카운트
따라서 최빈값은 없다
원본 화면의 보조 문구
30 / 77
R과 기술통계량 · 16/22
31. 기술통계학의 종류와 해석 - 중앙값
기술통계량 – 집중화 경향(Central Tendency)
수집한 데이터를 대표하는 값이 무엇인지 또는 어떤 값에 집중되어 있는지 다루는 통계량
| 최빈값 | 전체 자료들 중에서 가장 많은 빈도수를 나타낸 값 |
|---|---|
| 중앙값 | 전체 자료들을 가장 낮은 값에서 높은 값의 서열 순으로 나열했을 때 정확히 중간에 위치한 값 |
| 평균 | 전체 자료들을 합산한 후 이를 자료들의 개수로 나눈 값 |
원본 화면의 보조 문구
31 / 77
R과 기술통계량 · 17/22
32. AI & R Exercise - 중앙값
프롬프트:
- “이 데이터셋에서 phone_usage의 중앙값을 구해줘”
- “이 데이터셋에서 phone_usage의 중앙값을 구하기 위해 해당 변인 내의 각각의 값을 작은값부터 큰값 순서대로 배치해줘”
R 코드로 확인:
median(student_data$phone_usage)
눈으로 직접 확인
R 실행 결과
> median(student_data$phone_usage)
[1] 6.5
원본 화면의 보조 문구
32 / 77
R과 기술통계량 · 18/22
33. 기술통계량 예제 자료 – 중앙값 정답
| name | phone_usage | age | major |
|---|---|---|---|
| 학생5 | 4.3 | 20 | 화학공학 |
| 학생14 | 5.0 | 21 | 심리학 |
| 학생8 | 5.2 | 19 | 정치외교학 |
| 학생11 | 5.6 | 20 | 국문학 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 |
| 학생9 | 6.0 | 22 | 생명과학 |
| 학생12 | 6.3 | 23 | 수학 |
| 학생3 | 6.5 | 19 | 영문학 |
| name | phone_usage | age | major |
|---|---|---|---|
| 학생6 | 6.7 | 21 | 통계학 |
| 학생1 | 7.2 | 20 | 경영학 |
| 학생10 | 7.5 | 21 | 전자공학 |
| 학생7 | 7.9 | 20 | 경제학 |
| 학생4 | 8.1 | 22 | 물리학 |
| 학생13 | 8.5 | 19 | 건축공학 |
| 학생15 | 24.0 | 20 | 사회학 |
6.5가 위에서나 아래서나 정확히 8번째
따라서 중앙값은 6.5
원본 화면의 보조 문구
33 / 77
R과 기술통계량 · 19/22
34. 기술통계학의 종류와 해석 - 평균
기술통계량 – 집중화 경향(Central Tendency)
수집한 데이터를 대표하는 값이 무엇인지 또는 어떤 값에 집중되어 있는지 다루는 통계량
| 최빈값 | 전체 자료들 중에서 가장 많은 빈도수를 나타낸 값 |
|---|---|
| 중앙값 | 전체 자료들을 가장 낮은 값에서 높은 값의 서열 순으로 나열했을 때 정확히 중간에 위치한 값 |
| 평균 | 전체 자료들을 합산한 후 이를 자료들의 개수로 나눈 값 |
원본 화면의 보조 문구
34 / 77
R과 기술통계량 · 20/22
35. AI & R Exercise - 평균
프롬프트:
- “이 데이터셋에서 phone_usage의 평균값을 구해줘”
- “이 데이터셋에서 phone_usage의 평균값을 구하기 위한 계산과정을 보여주고 평균값을 구해줘”
R 코드로 확인:
mean(student_data$phone_usage)
직접 계산기로 계산해서 확인
R 실행 결과
> mean(student_data$phone_usage)
[1] 7.64
원본 화면의 보조 문구
35 / 77
R과 기술통계량 · 21/22
36. 기술통계량 예제 자료 – 평균값 정답
| name | phone_usage | age | major |
|---|---|---|---|
| 학생5 | 4.3 | 20 | 화학공학 |
| 학생14 | 5.0 | 21 | 심리학 |
| 학생8 | 5.2 | 19 | 정치외교학 |
| 학생11 | 5.6 | 20 | 국문학 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 |
| 학생9 | 6.0 | 22 | 생명과학 |
| 학생12 | 6.3 | 23 | 수학 |
| 학생3 | 6.5 | 19 | 영문학 |
| name | phone_usage | age | major |
|---|---|---|---|
| 학생6 | 6.7 | 21 | 통계학 |
| 학생1 | 7.2 | 20 | 경영학 |
| 학생10 | 7.5 | 21 | 전자공학 |
| 학생7 | 7.9 | 20 | 경제학 |
| 학생4 | 8.1 | 22 | 물리학 |
| 학생13 | 8.5 | 19 | 건축공학 |
| 학생15 | 24.0 | 20 | 사회학 |
다 더한값: 114.6
다 더한 값을 15개로 나눈값: 7.64
원본 화면의 보조 문구
36 / 77
R과 기술통계량 · 22/22
37. 평균의 함정
원본 화면의 보조 문구
37 / 77
평균의 함정 · 1/18
38. 기술통계량 예제 자료 – 평균값의 문제점: Outlier
| name | phone_usage | age | major |
|---|---|---|---|
| 학생5 | 4.3 | 20 | 화학공학 |
| 학생14 | 5.0 | 21 | 심리학 |
| 학생8 | 5.2 | 19 | 정치외교학 |
| 학생11 | 5.6 | 20 | 국문학 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 |
| 학생9 | 6.0 | 22 | 생명과학 |
| 학생12 | 6.3 | 23 | 수학 |
| 학생3 | 6.5 | 19 | 영문학 |
| name | phone_usage | age | major |
|---|---|---|---|
| 학생6 | 6.7 | 21 | 통계학 |
| 학생1 | 7.2 | 20 | 경영학 |
| 학생10 | 7.5 | 21 | 전자공학 |
| 학생7 | 7.9 | 20 | 경제학 |
| 학생4 | 8.1 | 22 | 물리학 |
| 학생13 | 8.5 | 19 | 건축공학 |
| 학생15 | 24.0 | 20 | 사회학 |
1명의 학생이 스마트폰을 24시간 사용한다 · 이 학생을 빼고 다시 계산해보면? 90.6 / 14 = 6.47
학생들 스마트폰 평균시간이 7.6시간이 아닌 6.5시간이다.
원본 화면의 보조 문구
38 / 77
평균의 함정 · 2/18
39. R-Studio 예제2: 다음의 코드를 그대로 Ctrl+C / Ctrl+V
student_data <- data.frame(
  name = c("학생1", "학생2", "학생3", "학생4", "학생5", "학생6", "학생7", "학생8",
           "학생9", "학생10", "학생11", "학생12", "학생13", "학생14", "학생15"),
  phone_usage = c(7.2, 5.8, 6.5, 8.1, 4.3, 6.7, 7.9, 5.2, 6.0, 7.5, 5.6, 6.3, 8.5, 5.0, 24.0),
  age = c(20, 21, 19, 22, 20, 21, 20, 19, 22, 21, 20, 23, 19, 21, 20),
  major = c("경영학", "컴퓨터공학", "영문학", "물리학", "화학공학", "통계학", "경제학",
            "정치외교학", "생명과학", "전자공학", "국문학", "수학", "건축공학", "심리학", "사회학"),
  salary = c(rep(5000, 14), 100000)
)
원본 화면의 보조 문구
39 / 77
평균의 함정 · 3/18
40. R-Studio 예제2: 연봉
| name | phone_usage | age | major | salary |
|---|---|---|---|---|
| 학생1 | 7.2 | 20 | 경영학 | 5000 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 | 5000 |
| 학생3 | 6.5 | 19 | 영문학 | 5000 |
| 학생4 | 8.1 | 22 | 물리학 | 5000 |
| 학생5 | 4.3 | 20 | 화학공학 | 5000 |
| 학생6 | 6.7 | 21 | 통계학 | 5000 |
| 학생7 | 7.9 | 20 | 경제학 | 5000 |
| 학생8 | 5.2 | 19 | 정치외교학 | 5000 |
| name | phone_usage | age | major | salary |
|---|---|---|---|---|
| 학생9 | 6.0 | 22 | 생명과학 | 5000 |
| 학생10 | 7.5 | 21 | 전자공학 | 5000 |
| 학생11 | 5.6 | 20 | 국문학 | 5000 |
| 학생12 | 6.3 | 23 | 수학 | 5000 |
| 학생13 | 8.5 | 19 | 건축공학 | 5000 |
| 학생14 | 5.0 | 21 | 심리학 | 5000 |
| 학생15 | 24.0 | 20 | 사회학 | 100000 |
원본 화면의 보조 문구
40 / 77
평균의 함정 · 4/18
41. AI & R Exercise - 평균
프롬프트:
- “이 데이터셋에서 salary의 평균값을 구해줘”
- “이 데이터셋에서 salary 의 평균값을 구하기 위한 계산과정을 보여주고 평균값을 구해줘”
R 코드로 확인:
mean(student_data$salary)
R 실행 결과
> mean(student_data$salary)
[1] 11333.33
원본 화면의 보조 문구
41 / 77
평균의 함정 · 5/18
42. R-Studio 예제2: 연봉 평균 정답
| name | phone_usage | age | major | salary |
|---|---|---|---|---|
| 학생1 | 7.2 | 20 | 경영학 | 5000 |
| 학생2 | 5.8 | 21 | 컴퓨터공학 | 5000 |
| 학생3 | 6.5 | 19 | 영문학 | 5000 |
| 학생4 | 8.1 | 22 | 물리학 | 5000 |
| 학생5 | 4.3 | 20 | 화학공학 | 5000 |
| 학생6 | 6.7 | 21 | 통계학 | 5000 |
| 학생7 | 7.9 | 20 | 경제학 | 5000 |
| 학생8 | 5.2 | 19 | 정치외교학 | 5000 |
| name | phone_usage | age | major | salary |
|---|---|---|---|---|
| 학생9 | 6.0 | 22 | 생명과학 | 5000 |
| 학생10 | 7.5 | 21 | 전자공학 | 5000 |
| 학생11 | 5.6 | 20 | 국문학 | 5000 |
| 학생12 | 6.3 | 23 | 수학 | 5000 |
| 학생13 | 8.5 | 19 | 건축공학 | 5000 |
| 학생14 | 5.0 | 21 | 심리학 | 5000 |
| 학생15 | 24.0 | 20 | 사회학 | 100000 |
R-Studio 코드 결과: 11333.33
1인당 연봉 1억 1333만원
원본 화면의 보조 문구
42 / 77
평균의 함정 · 6/18
43. 평균의 함정
- 아, 평균 연봉이 11333만원이 나왔으니까 한림대 학생들 연봉이 평균 1억원이 넘는구나! = 평균의 함정
- 10억원이 넘는 특이한 사람 한 명때문에 평균 연봉에 거품이 낀다
- 그 ‘특이한 사람’이 통계 결과를 이상하게 만드는데, ‘특이한 사람’을 통계학에서 Outlier라고 한다
원본 화면의 보조 문구
43 / 77
평균의 함정 · 7/18
44. 대한민국 중위소득
https://www.index.go.kr/unify/idx-info.do?idxCd=8001
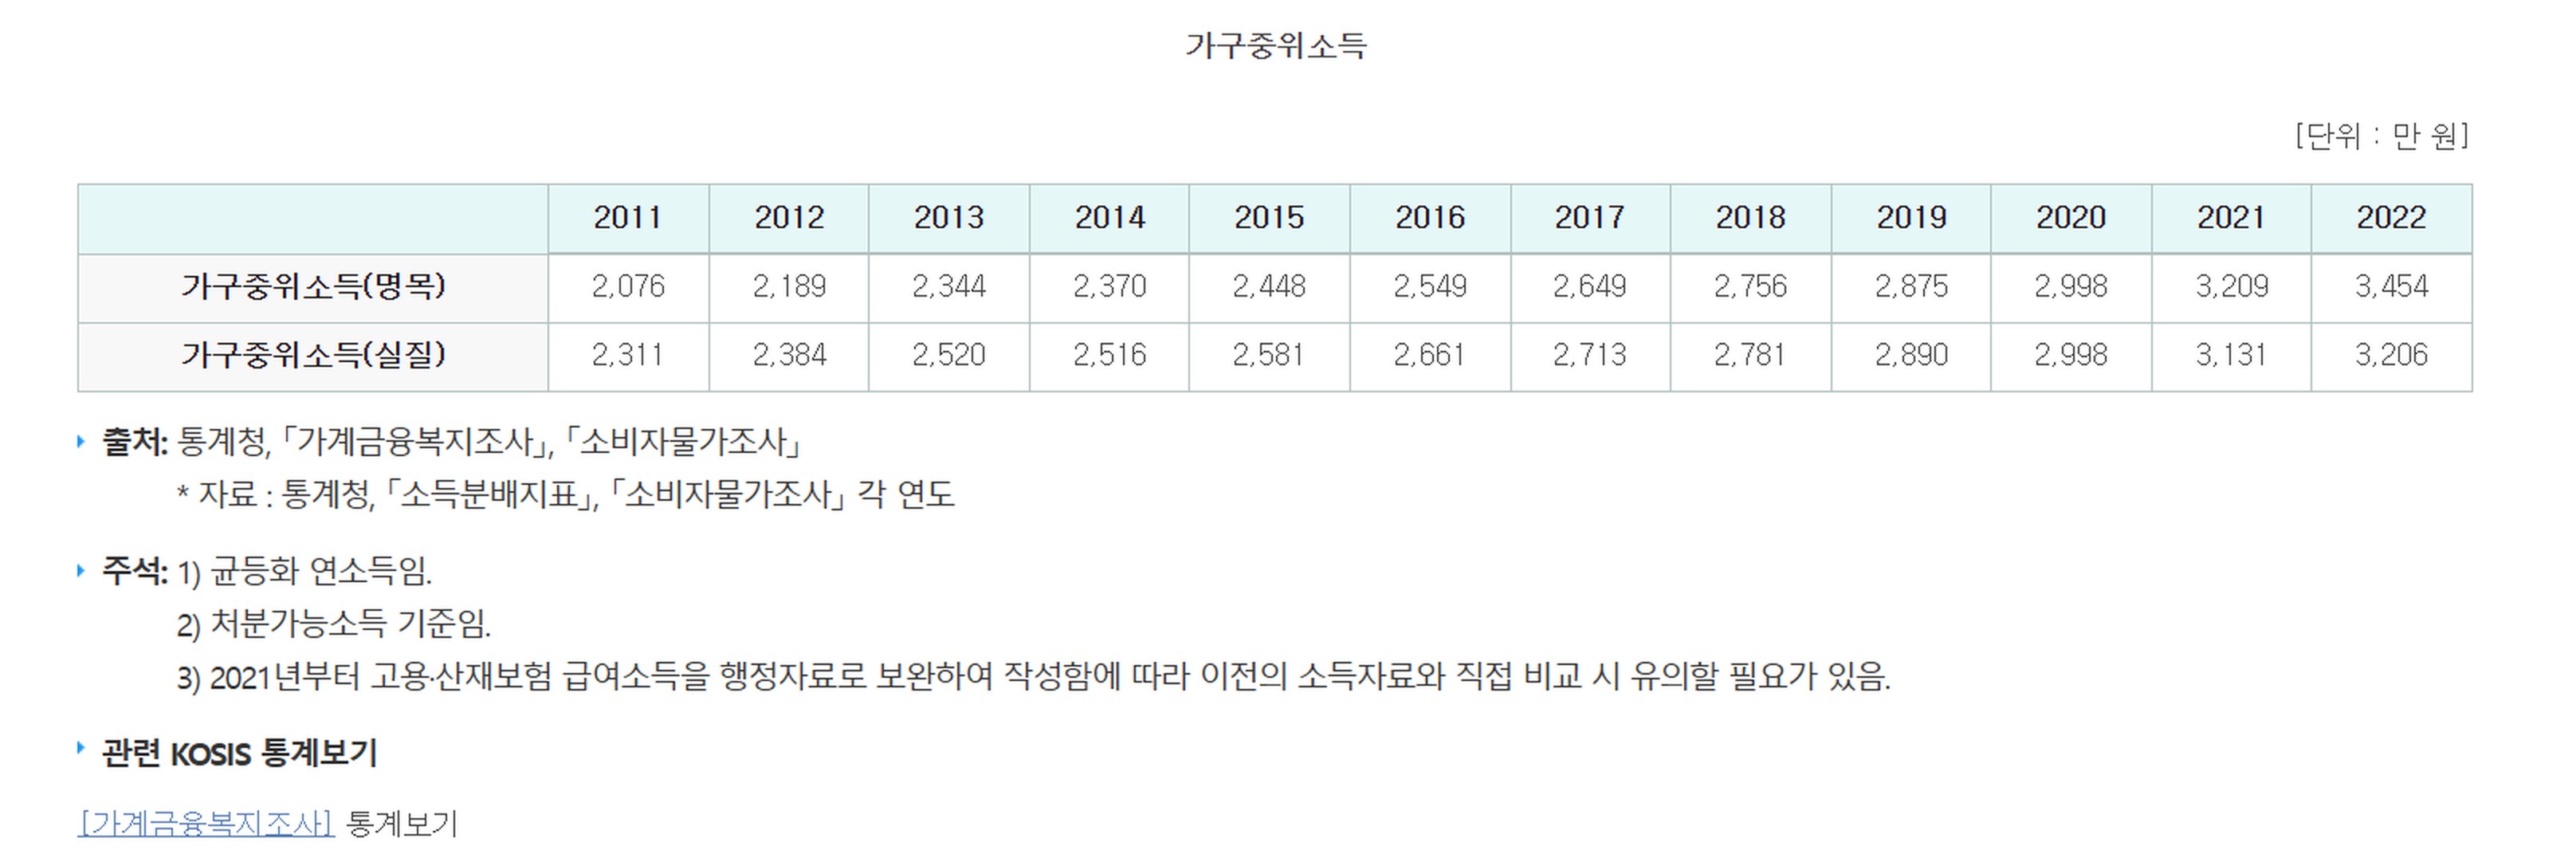
국가지표체계 ‘가구중위소득’ 표 화면: 2011~2022년 가구중위소득(명목·실질)과 출처·주석
원본 화면의 보조 문구
44 / 77
평균의 함정 · 8/18
45. 대한민국 기준 중위소득 추이 (가구 숫자별)
https://www.index.go.kr/unity/potal/main/EachDtlPageDetail.do?idx_cd=2762
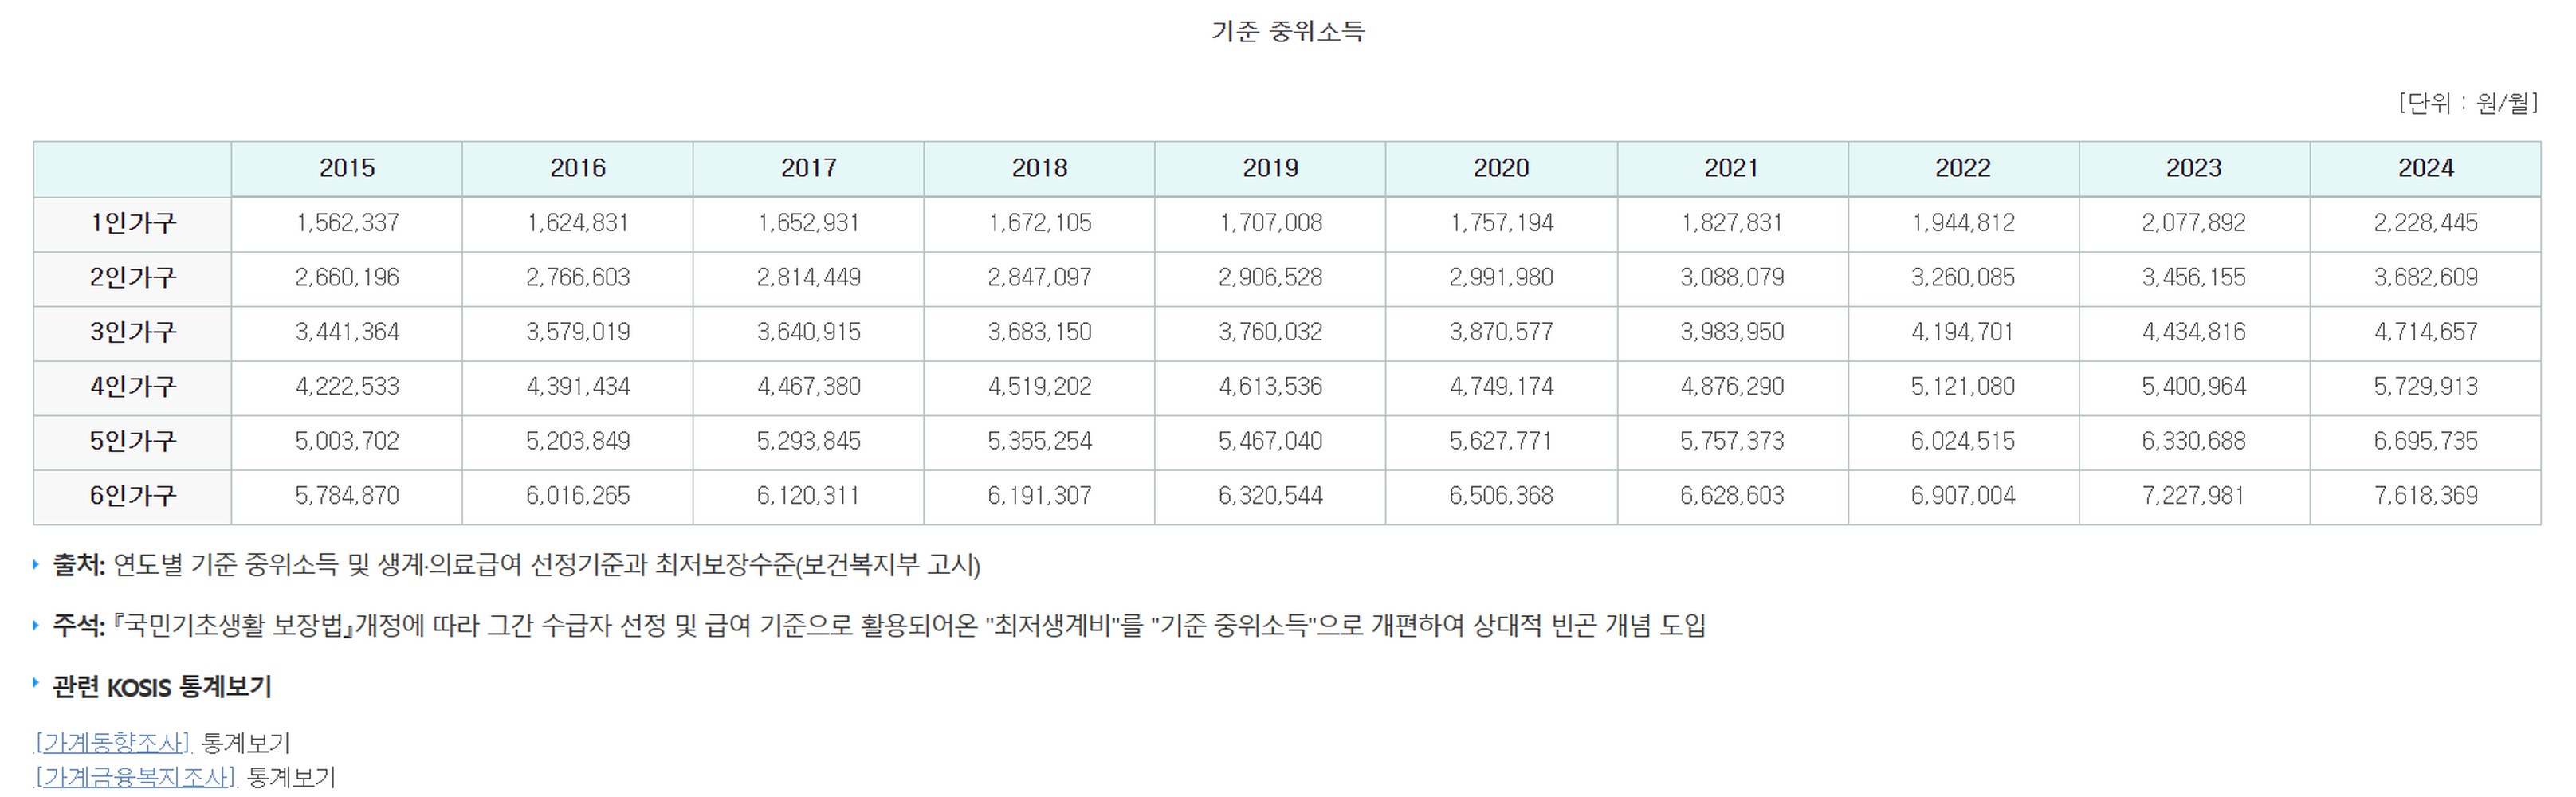
국가지표체계 ‘기준 중위소득’ 표 화면: 2015~2024년 1인~7인 가구별 기준 중위소득과 출처·주석
원본 화면의 보조 문구
45 / 77
평균의 함정 · 9/18
46. 기술통계학의 종류와 해석
분산과 표준편차
- 분산 : 데이터가 퍼져 있는 정도의 기준으로 평균(X̄) 사용
- 표준편차 : 평균을 중심으로 일정한 거리에 포함된 데이터의 비율을 계산할 때 사용하는 척도
더 쉽게 말해, 평균값을 낮은애들부터 높은애들까지 가로로 늘어놓았을때 전체 평균값이 어떻게 퍼져있는지를 보여주는 지도
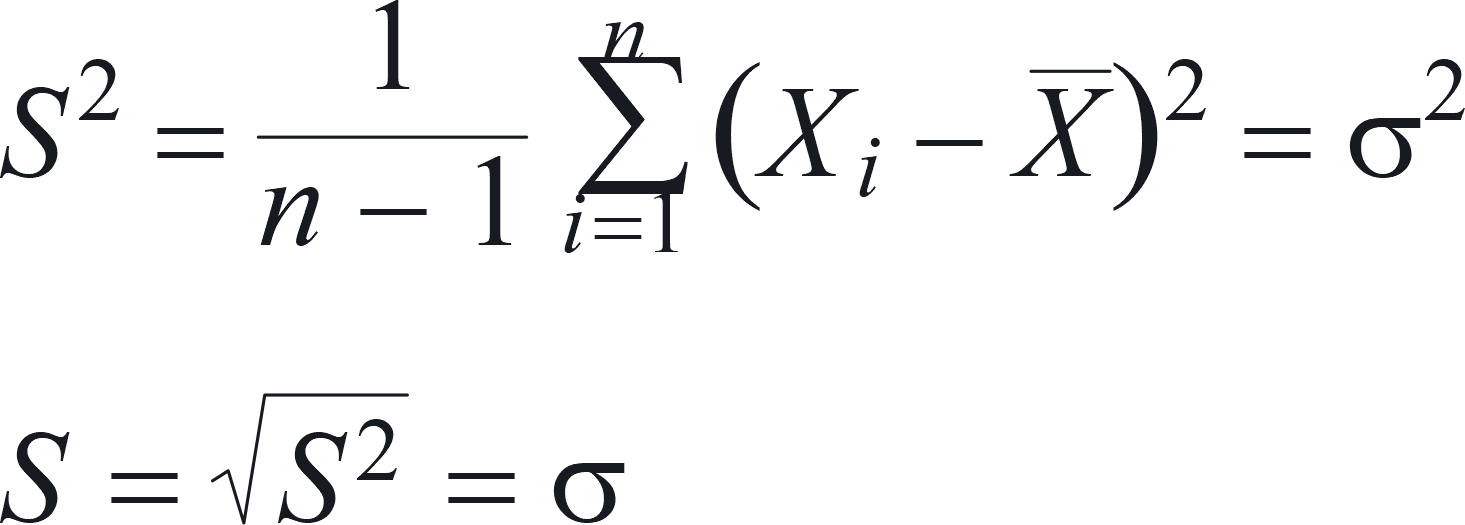
원본 화면의 보조 문구
46 / 77
평균의 함정 · 10/18
47. 기술통계학의 종류와 해석
68-95 법칙
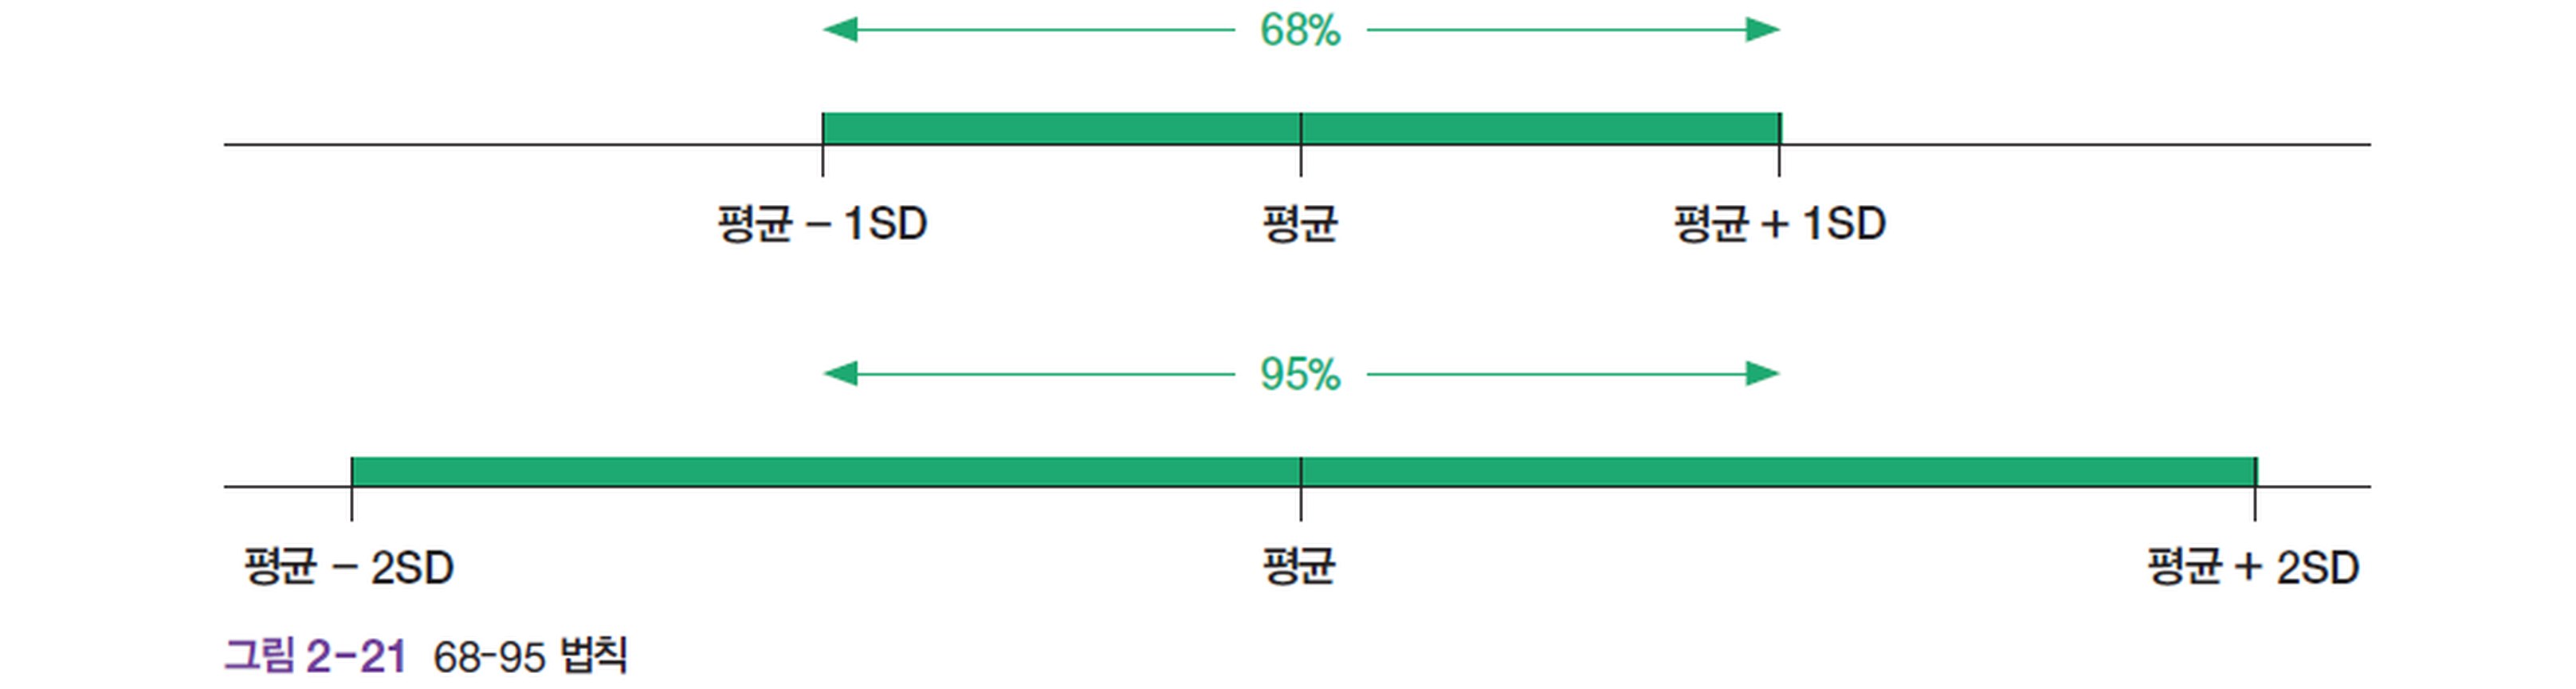
그림 2-21 68-95 법칙: 평균−1SD부터 평균+1SD까지 68%, 평균−2SD부터 평균+2SD까지 95%를 나타내는 두 막대
원본 화면의 보조 문구
47 / 77
평균의 함정 · 11/18
48. 기술통계학의 종류와 해석
첨도
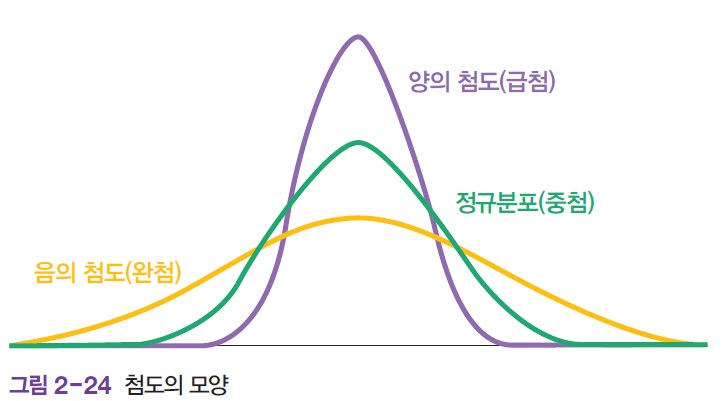
양의 첨도:
비트코인에 투자한 애들이 엄청 몰려있더라
음의 첨도:
비트코인에 물려서 많이 손절해서 코인 가진애들이 작년보다 더 줄었더라
원본 화면의 보조 문구
48 / 77
평균의 함정 · 12/18
49. 기술통계학의 종류와 해석
왜도
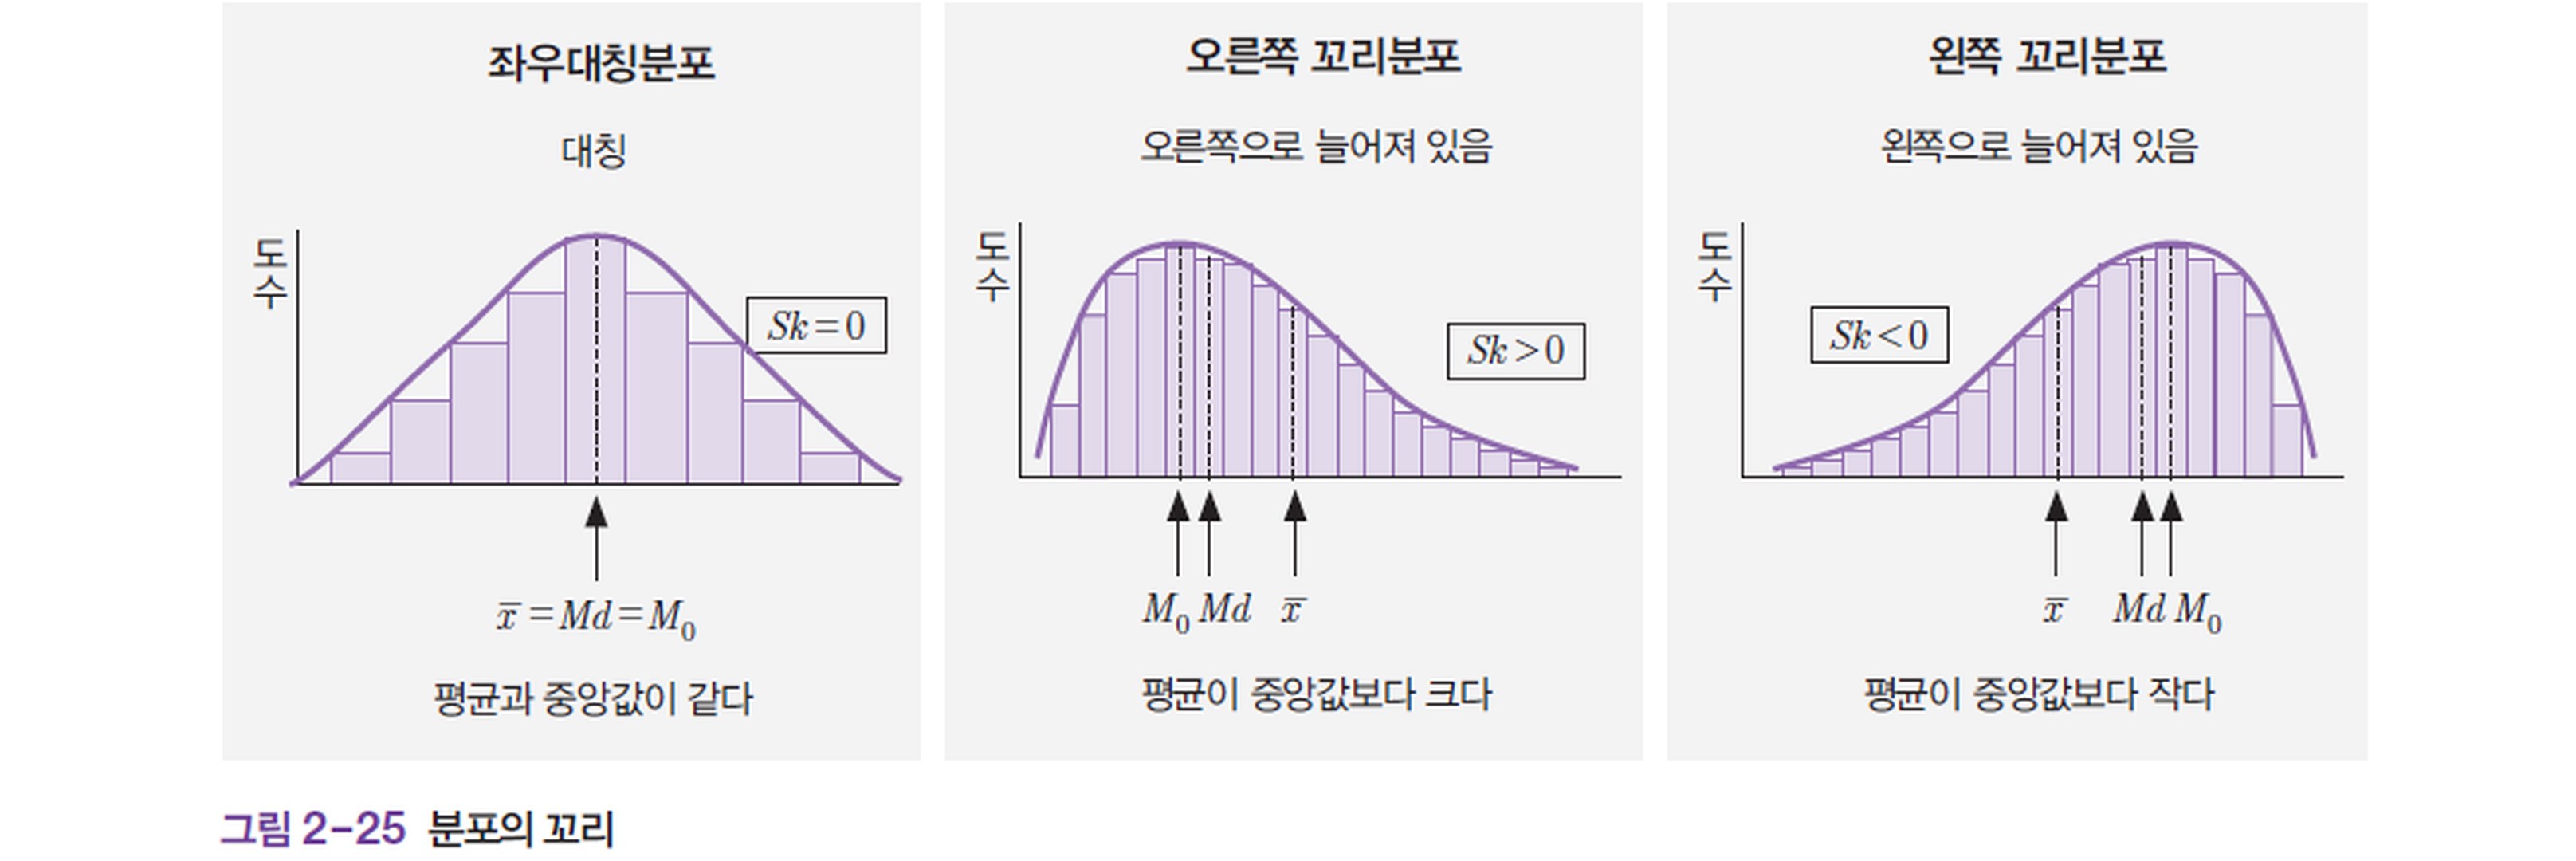
그림 2-25 분포의 꼬리: 좌우대칭분포(평균=중앙값=최빈값), 오른쪽 꼬리분포(평균이 중앙값보다 크다), 왼쪽 꼬리분포(평균이 중앙값보다 작다)
원본 화면의 보조 문구
49 / 77
평균의 함정 · 13/18
50. R-Studio 예제2: 다음의 코드를 그대로 Ctrl+C / Ctrl+V
# 표준편차 곡선을 그리는 코드
curve(dnorm(x, mean = mean(student_data$salary), sd = sd(student_data$salary)),
      from = min(student_data$salary),
      to = max(student_data$salary),
      xlab = "Salary",
      ylab = "Density",
      main = "연봉 분포와 표준편차 곡선",
      col = "blue",
      lwd = 2)

# 연봉 분포를 세로선으로 표시
abline(v = student_data$salary, col = "red", lty = 2)
원본 화면의 보조 문구
50 / 77
평균의 함정 · 14/18
51. R-Studio 예제 2: 연봉 10억원 학생이 낀 연봉평균의 분포도
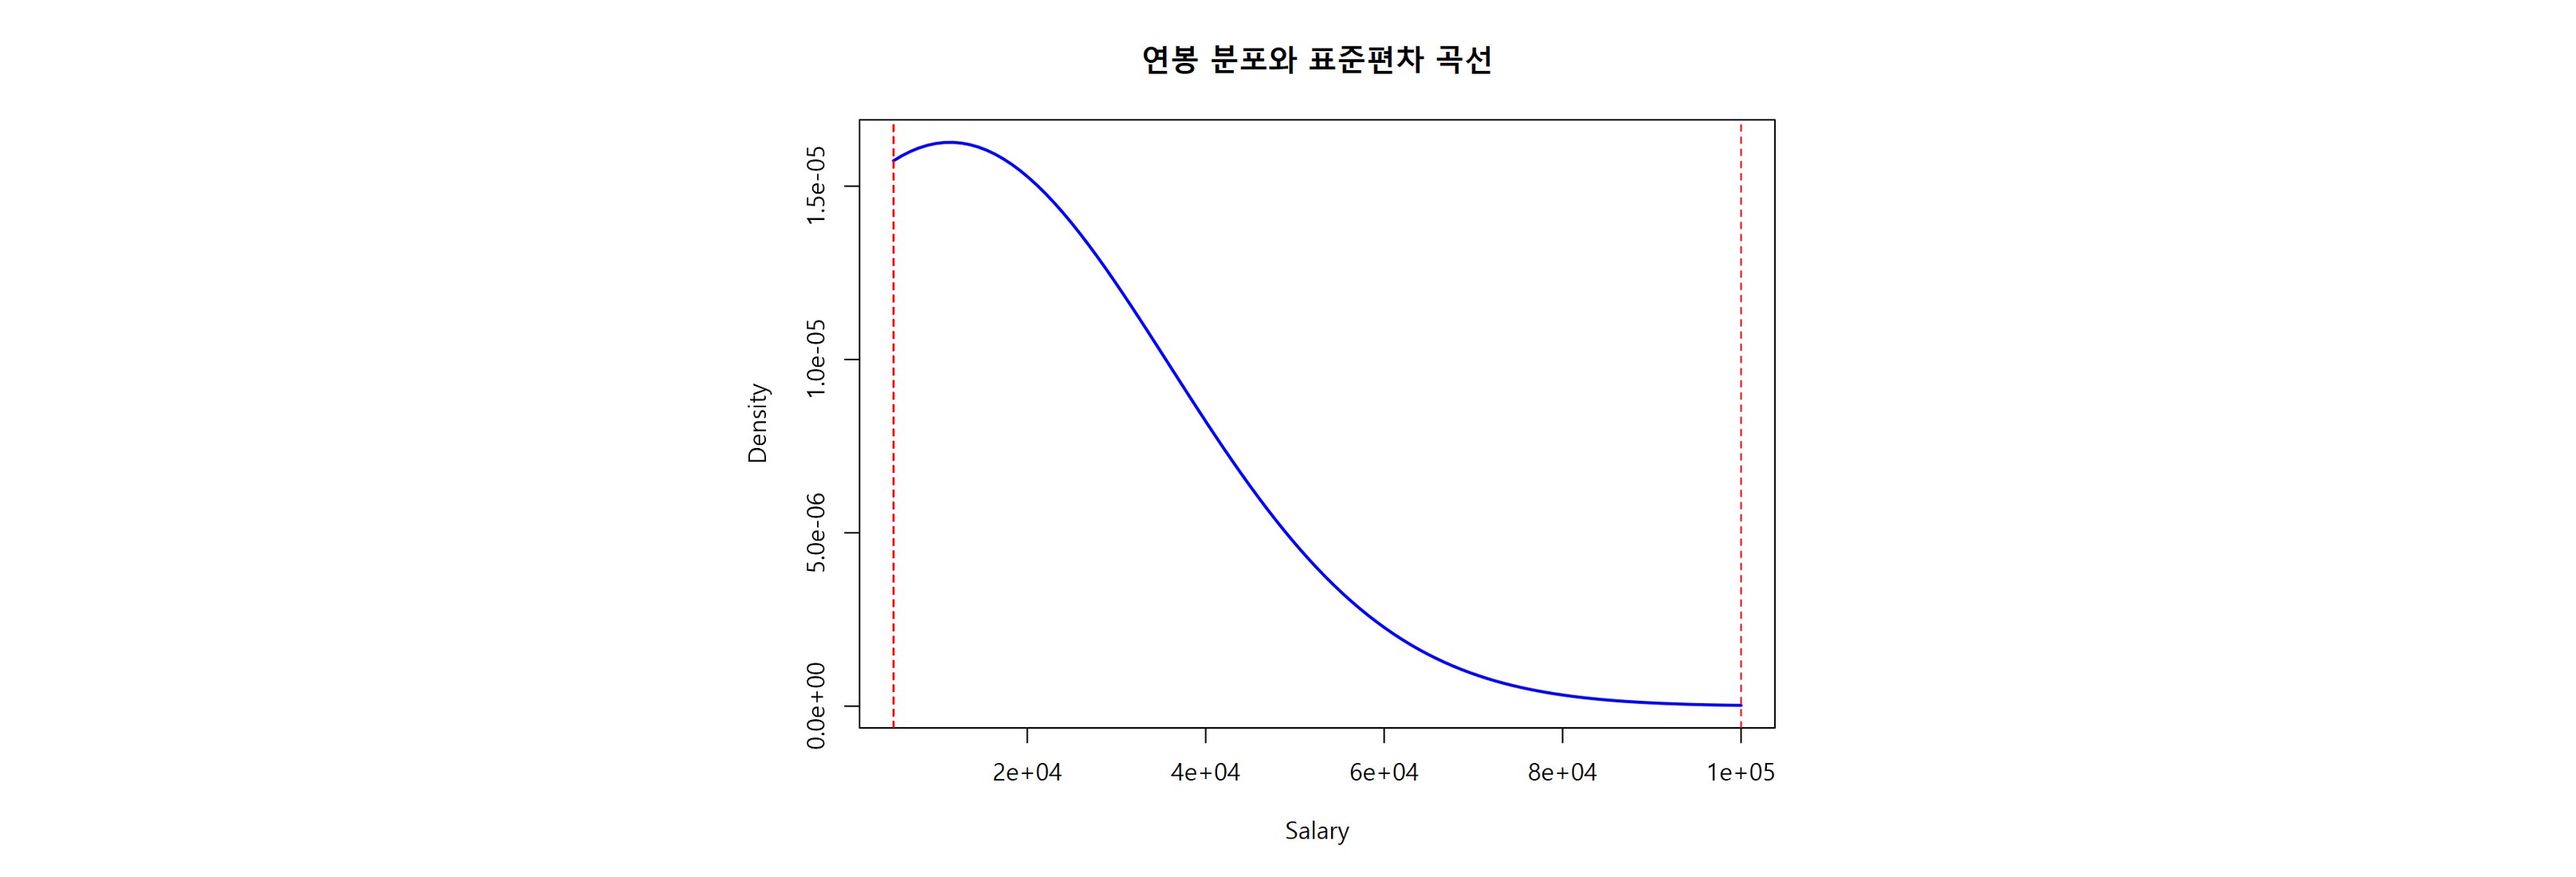
R 그래프 ‘연봉 분포와 표준편차 곡선’: 정규분포 곡선이 왼쪽에서 정점을 찍고 오른쪽으로 길게 떨어진다. 5000(14명)과 100000(1명)에 빨간 점선이 세로로 그어져 있다.
원본 화면의 보조 문구
51 / 77
평균의 함정 · 15/18
52. R-Studio 예제2: 다음의 코드를 그대로 Ctrl+C / Ctrl+V
# 정규분포를 따르는 salary 값을 생성하는 코드
set.seed(42)  # 랜덤 시드를 설정하여 재현성을 보장합니다.

# 평균과 표준편차 지정
mean_salary <- mean(student_data$salary)
sd_salary <- sd(student_data$salary)

# 정규분포에 따르는 새로운 salary 값 생성
new_salary <- rnorm(n = nrow(student_data), mean = mean_salary, sd = sd_salary)

# 생성한 값들을 데이터프레임에 할당
student_data$salary <- new_salary

# 수정된 salary 값 출력
print(student_data$salary)
원본 화면의 보조 문구
52 / 77
평균의 함정 · 16/18
53. R-Studio 예제 2: 연봉이 골고루인 학생들의 정규분포도
R 실행 결과
> print(student_data$salary)
 [1]  44961.428  -2518.089  20240.472
 [4]  26856.753  21249.588   8730.216
 [7]  48409.297   9011.452  60843.036
[10]   9795.026  43340.343  67422.217
[13] -22733.884   4494.953   8063.108
원본 화면의 보조 문구
53 / 77
평균의 함정 · 17/18
54. 정리
| 최빈값 | 전체 자료들 중에서 가장 많은 빈도수를 나타낸 값 |
|---|---|
| 중앙값 | 전체 자료들을 가장 낮은 값에서 높은 값의 서열 순으로 나열했을 때 정확히 중간에 위치한 값 |
| 평균 | 전체 자료들을 합산한 후 이를 자료들의 개수로 나눈 값 |
분산과 표준편차: 평균값을 낮은애들부터 높은애들까지 가로로 늘어놓았을때 전체 평균값이 어떻게 퍼져있는지를 보여주는 지도
셋 중에 보통 평균값이 제일 흔하지만 연봉의 경우처럼 평균값이 적용 안되는 경우도 있다 (평균값이 만능이 아니다!)
원본 화면의 보조 문구
54 / 77
평균의 함정 · 18/18
55. 추론통계학이란?
원본 화면의 보조 문구
55 / 77
추론통계학 · 1/23
56. 추론통계학이란?
추론통계학 기본 절차
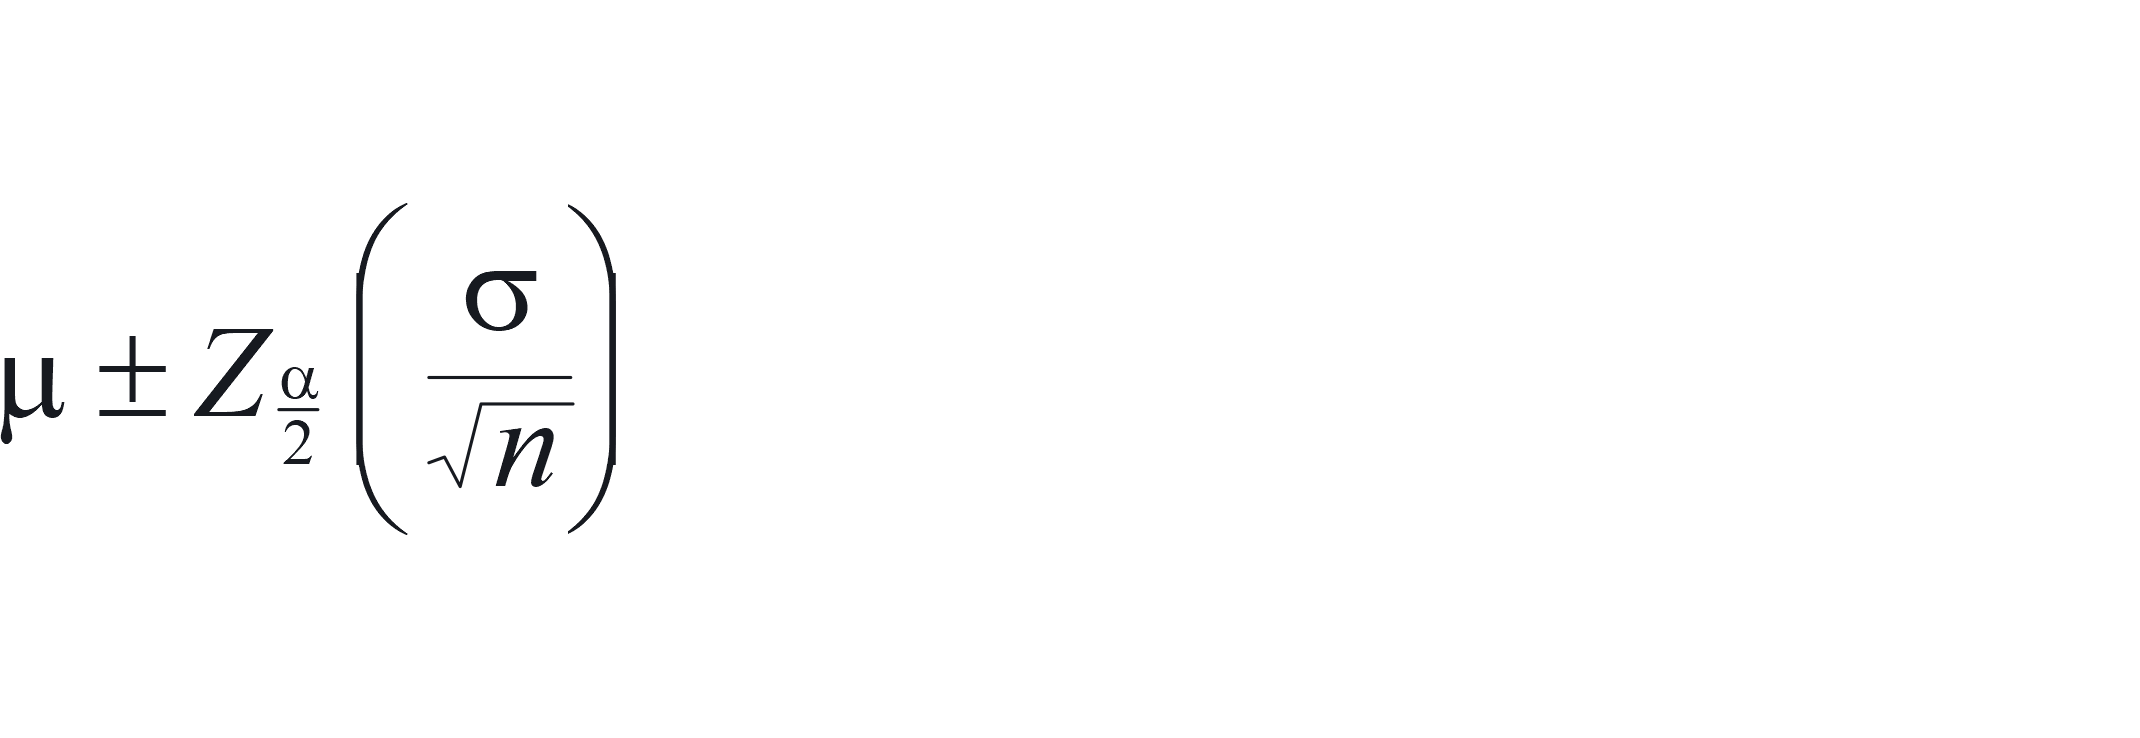
추론통계학이란? 표본 데이터를 사용하여 모집단에 대한 통계적 추론을 수행하는 분석 방법
평균과 분산
| 표본평균 | X̄ |
|---|---|
| 모집단평균 추정치 | μ = X̄ |
| 표본분산 | S² |
| 모집단분산 추정치 | σ² = S²/n |
신뢰구간
원본 화면의 보조 문구
56 / 77
추론통계학 · 2/23
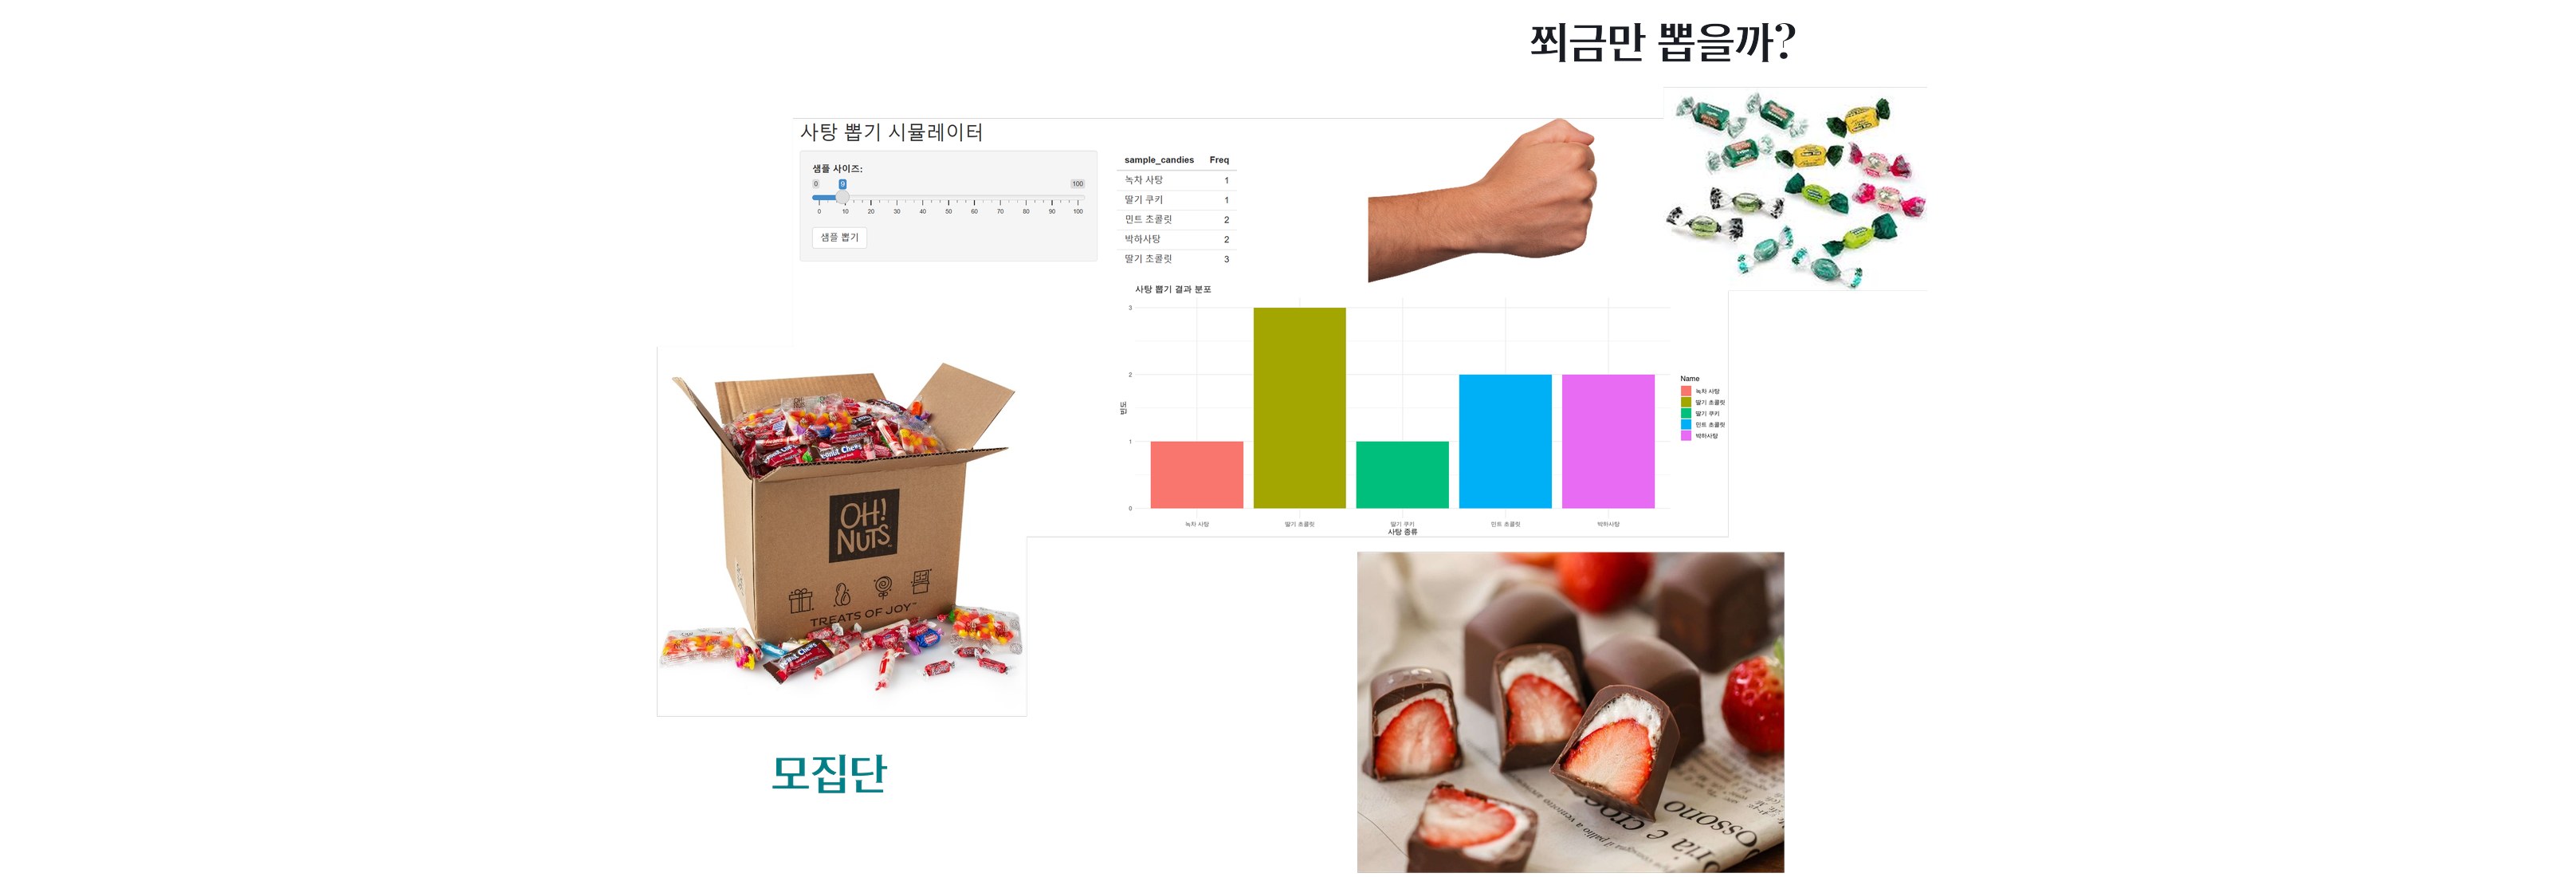
57. 모집단과 샘플 – 전체 상자에는 딸기 초콜릿이 얼마나 있을까?
사탕 뽑기 시뮬레이터 화면, 오른쪽 위 ‘쬐금만 뽑을까?’ 주먹과 사탕 몇 개, 왼쪽 아래 사탕 상자(모집단), 오른쪽 아래 딸기 초콜릿 사진
원본 화면의 보조 문구
57 / 77
추론통계학 · 3/23
58. 주먹으로 사탕을 뽑아봅시다.
모집단
방법은 상관없다. 상자 전체에 들어있는 딸기 초콜릿 사탕의 정확한 비율이 뭐냐?
조금만 뽑을까?
샘플1
OR · 주먹이 터지게 가득 뽑을까?
샘플2
왼쪽부터 사탕이 가득한 상자(모집단), 주먹과 몇 개 안 되는 사탕(샘플1), 주먹과 가득 쌓인 풍선껌(샘플2) 사진
원본 화면의 보조 문구
58 / 77
추론통계학 · 4/23
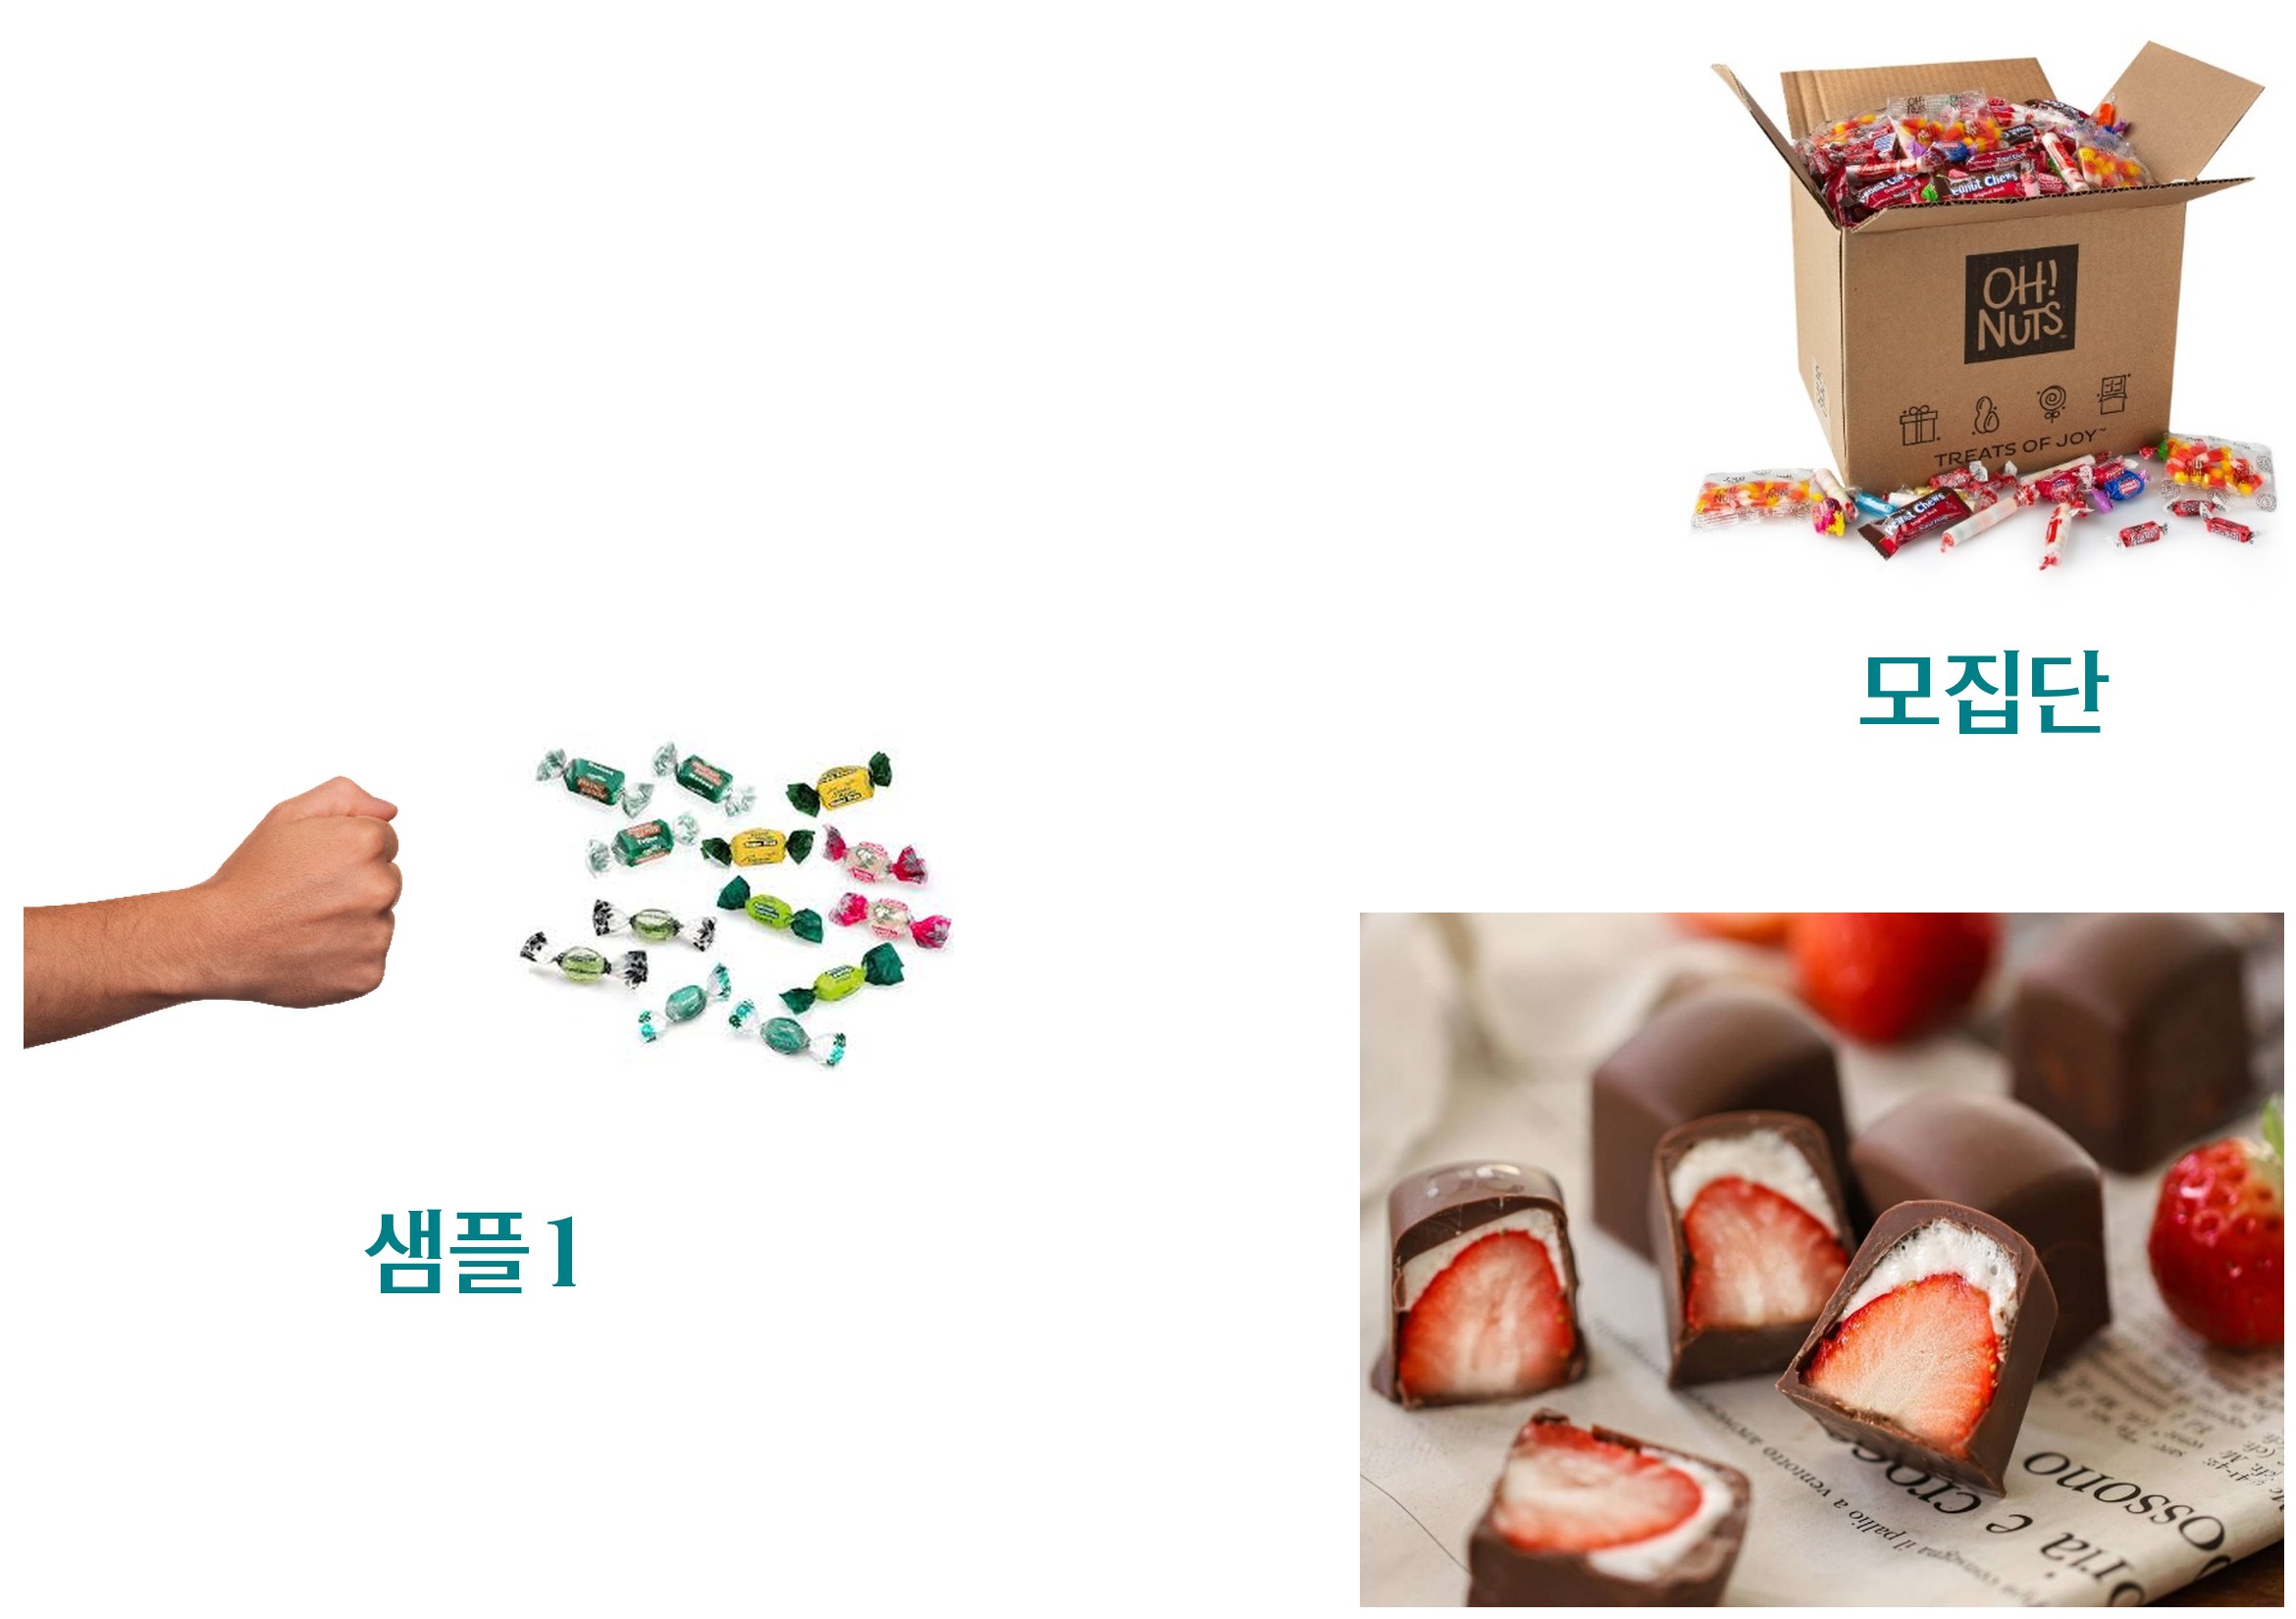
59. RQ. 원래 사탕 전체에는 딸기 초콜릿 사탕이 총 몇개일까
할로윈 캔디 상자
- 모집단: 캔디 상자에 있는 전체 사탕
- 샘플: 상자에서 내가 주먹으로 뽑은 사탕
원본 화면의 보조 문구
59 / 77
추론통계학 · 5/23
60. RQ. 원래 사탕 전체에는 딸기 초콜릿 사탕이 총 몇개일까
모집단
상자에 “딸기초콜릿만” 몇 개인지 알고싶어
설마 이 상자를 다 뜯어서 일일히 세보려구요?
원본 화면의 보조 문구
60 / 77
추론통계학 · 6/23
61. 내 손안에 있는 사탕만 세보자 (원래 상자는 생각 말고)
사탕 뽑기 시뮬레이터 화면: 왼쪽 위에 뽑을 개수 슬라이더와 뽑힌 사탕 종류별 개수 표, 아래에 종류별 막대그래프. 아래에 주먹과 사탕 몇 개, 딸기 초콜릿 사진
원본 화면의 보조 문구
61 / 77
추론통계학 · 7/23
62. 내 손안에 있는 사탕만 세보자 (원래 상자는 생각 말고)
https://posit.cloud/content/5906664
https://posit.cloud/content/7862513
사탕뽑기 시뮬레이터 R-Studio 코드.R 참조
원본 화면의 보조 문구
62 / 77
추론통계학 · 8/23
63. 사탕 뽑기 시뮬레이터 – 웹에서 뽑아보기
브라우저에서 바로 실행: https://claude.ai/artifact/B3vs3qRXH6HRe755AbKnyh
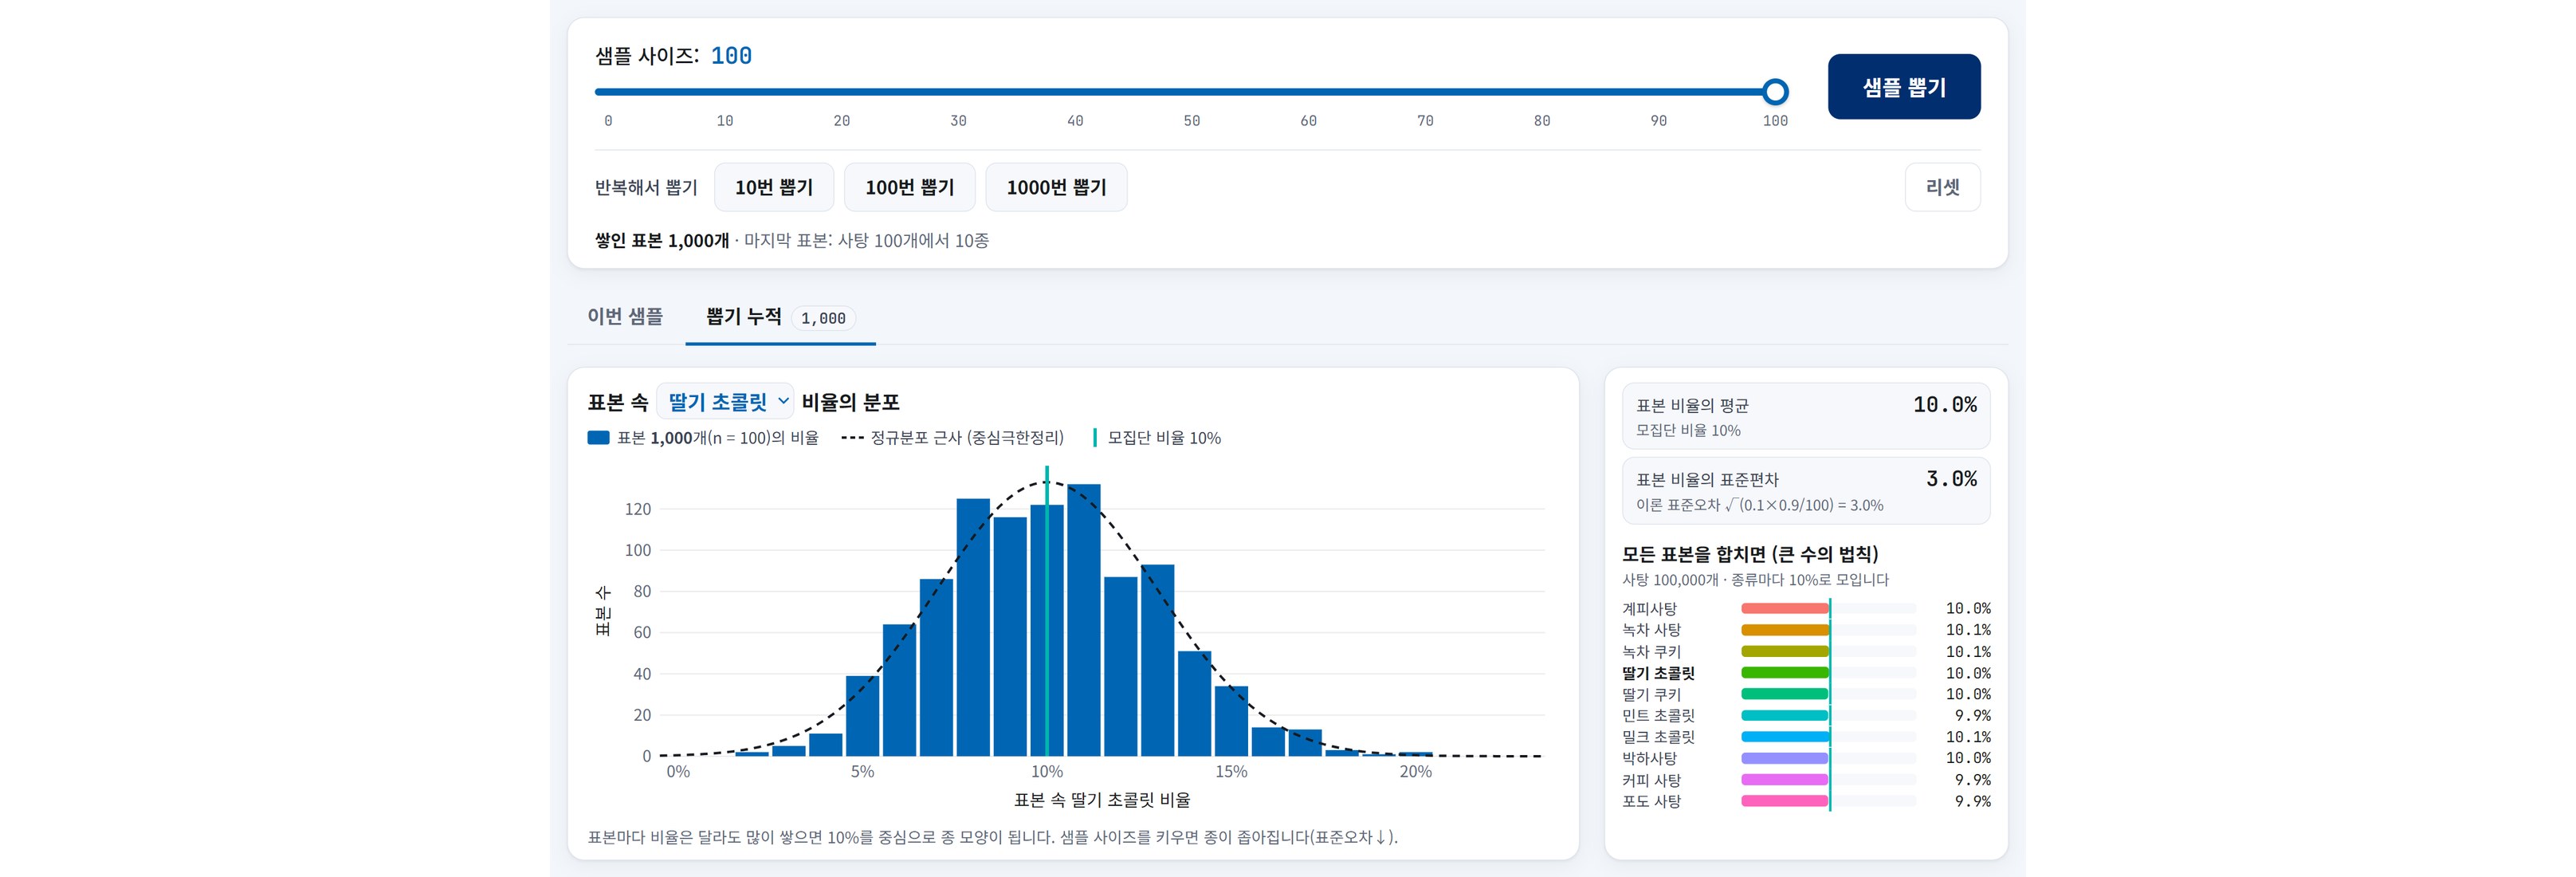
사탕 뽑기 시뮬레이터 웹 화면: 샘플 사이즈 100 슬라이더와 [샘플 뽑기]·[10번·100번·1000번 뽑기]·[리셋] 버튼, ‘뽑기 누적’ 탭에 표본 1,000개의 딸기 초콜릿 비율 히스토그램(10%를 중심으로 한 종 모양과 정규분포 점선), 오른쪽에 표본 비율의 평균·표준편차와 사탕 10종을 모두 합친 비율
원본 화면의 보조 문구
63 / 77
추론통계학 · 9/23
64. Exercise. 사탕 뽑기 시뮬레이터로 사탕갯수와 딸기초콜릿을 세보자
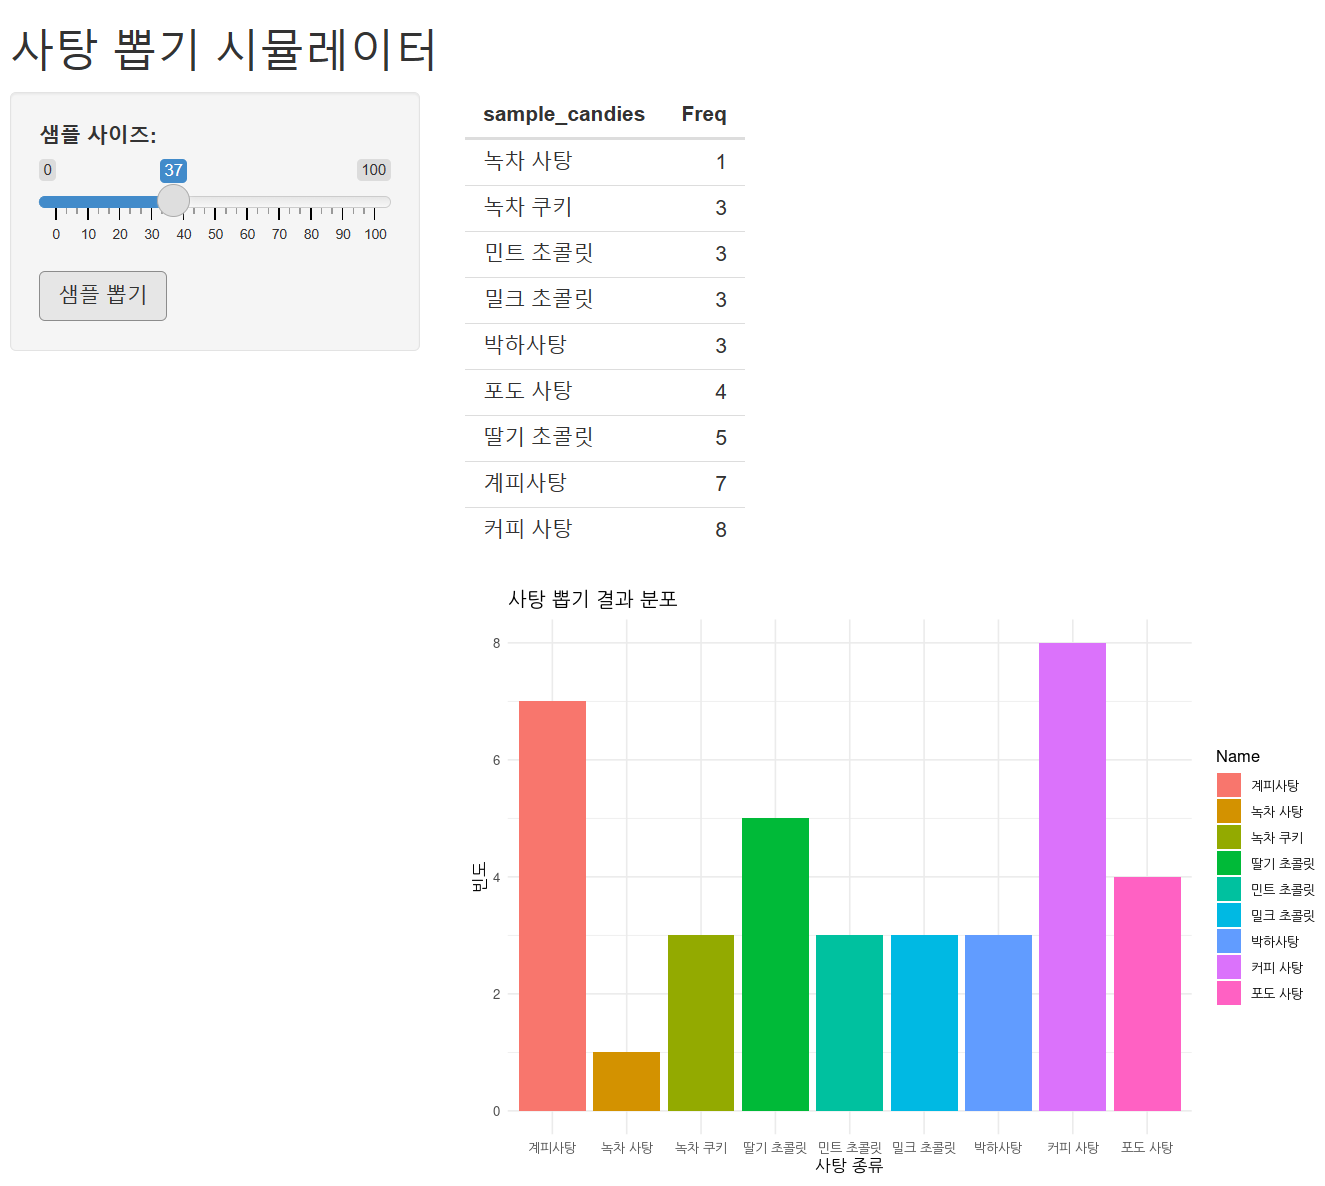
| 사탕갯수 | 딸기초콜릿 | |
|---|---|---|
| 샘플1 | ||
| 샘플2 | ||
| 샘플3 | ||
| 샘플4 | ||
| 샘플5 |
원본 화면의 보조 문구
64 / 77
추론통계학 · 10/23
65. RQ. 원래 사탕 전체에는 딸기 초콜릿 사탕이 총 몇개일까
모집단
상자에 “딸기초콜릿만” 몇 개인지 알고싶어
추론 통계학: 샘플의 딸기초콜릿 비율을 통해서 원래 상자의 딸기 초콜릿 비율을 추정하는 것
| 사탕갯수 | 딸기초콜릿 | |
|---|---|---|
| 샘플1 | ||
| 샘플2 | ||
| 샘플3 | ||
| 샘플4 | ||
| 샘플5 |
원본 화면의 보조 문구
65 / 77
추론통계학 · 11/23
66. RQ. 원래 사탕 전체에는 딸기 초콜릿 사탕이 총 몇개일까
모집단
| 사탕갯수 | 딸기초콜릿 | |
|---|---|---|
| 샘플1 | ||
| 샘플2 | ||
| 샘플3 | ||
| 샘플4 | ||
| 샘플5 |
추론 통계학:
- 샘플의 딸기초콜릿 비율을 통해서 원래 상자의 딸기 초콜릿 비율을 추정하는 것
- “내 주먹에 있는 딸기초콜릿이 몇 개인데, 그걸로 봤을때 원래 상자에 딸기 초콜릿을 전부 세면 몇개쯤 나올거 같지?” – 추정 (Estimation)
원본 화면의 보조 문구
66 / 77
추론통계학 · 12/23
67. RQ. 원래 사탕 전체에는 딸기 초콜릿 사탕이 총 몇개일까
딸기 초콜릿 데이터셋 만들기 (R-Studio 코드)
# 데이터 프레임 생성
candy_data <- data.frame(
  Sample = c('샘플1', '샘플2', '샘플3', '샘플4', '샘플5'),
  Total_Candies = c(100, 100, 100, 100, 100),
  Strawberry_Chocolate = c(8, 7, 12, 9, 9)
)

# 데이터 확인
print(candy_data)
Note: 실제 뽑은 개수가 다르면 Total과 Strawberry 숫자를 고칠것
원본 화면의 보조 문구
67 / 77
추론통계학 · 13/23
68. 딸기 초콜릿의 기술통계량 구하기
#최빈값:
freq <- table(candy_data$Strawberry_Chocolate)
maxfreq <- max(freq)
which(freq == maxfreq)
table(candy_data$Strawberry_Chocolate)
#중앙값:
median(candy_data$Strawberry_Chocolate)
#평균값:
mean(candy_data$Strawberry_Chocolate)
#분산:
var(candy_data$Strawberry_Chocolate)
#표준편차:
sd(candy_data$Strawberry_Chocolate)
Note: candy_data$Strawberry_Chocolate 는 ‘데이터셋$변수명’의 구조이다 기술통계량 공식은 나머지는 옆에 공식 그대로 쓰면 됨
원본 화면의 보조 문구
68 / 77
추론통계학 · 14/23
69. 딸기 초콜릿의 기술통계량 구하기 – R 실행 결과
> which(freq == maxfreq)
9
3
> table(candy_data$Strawberry_Chocolate)

 7  8  9 12
 1  1  2  1
> median(candy_data$Strawberry_Chocolate)
[1] 9
> mean(candy_data$Strawberry_Chocolate)
[1] 9
> var(candy_data$Strawberry_Chocolate)
[1] 3.5
> sd(candy_data$Strawberry_Chocolate)
[1] 1.870829
원본 화면의 보조 문구
69 / 77
추론통계학 · 15/23
70. 추론통계학: 상자 전체의 딸기 초콜릿 개수 추정하기
# t.test를 사용하여 신뢰구간 계산
t.test(candy_data$Strawberry_Chocolate)$conf.int
R 실행 결과
> t.test(candy_data$Strawberry_Chocolate)$conf.int
[1]  6.677059 11.322941
attr(,"conf.level")
[1] 0.95
Note: candy_data$Strawberry_Chocolate 는 ‘데이터셋$변수명’의 구조이다
기술통계량 공식은 나머지는 옆에 공식 그대로 쓰면 됨
원본 화면의 보조 문구
70 / 77
추론통계학 · 16/23
71. 추론통계학: 상자 전체의 딸기 초콜릿 개수 추정하기
# t.test를 사용하여 신뢰구간 계산
t.test(candy_data$Strawberry_Chocolate)$conf.int
t.test결과
> t.test(candy_data$Strawberry_Chocolate)$conf.int
[1]  6.677059 11.322941
attr(,"conf.level")
[1] 0.95
즉, 전체 상자에는 딸기 초콜릿이 6.68개~11.32개 사이의 딸기 초콜릿이 있을 확률이 95%다
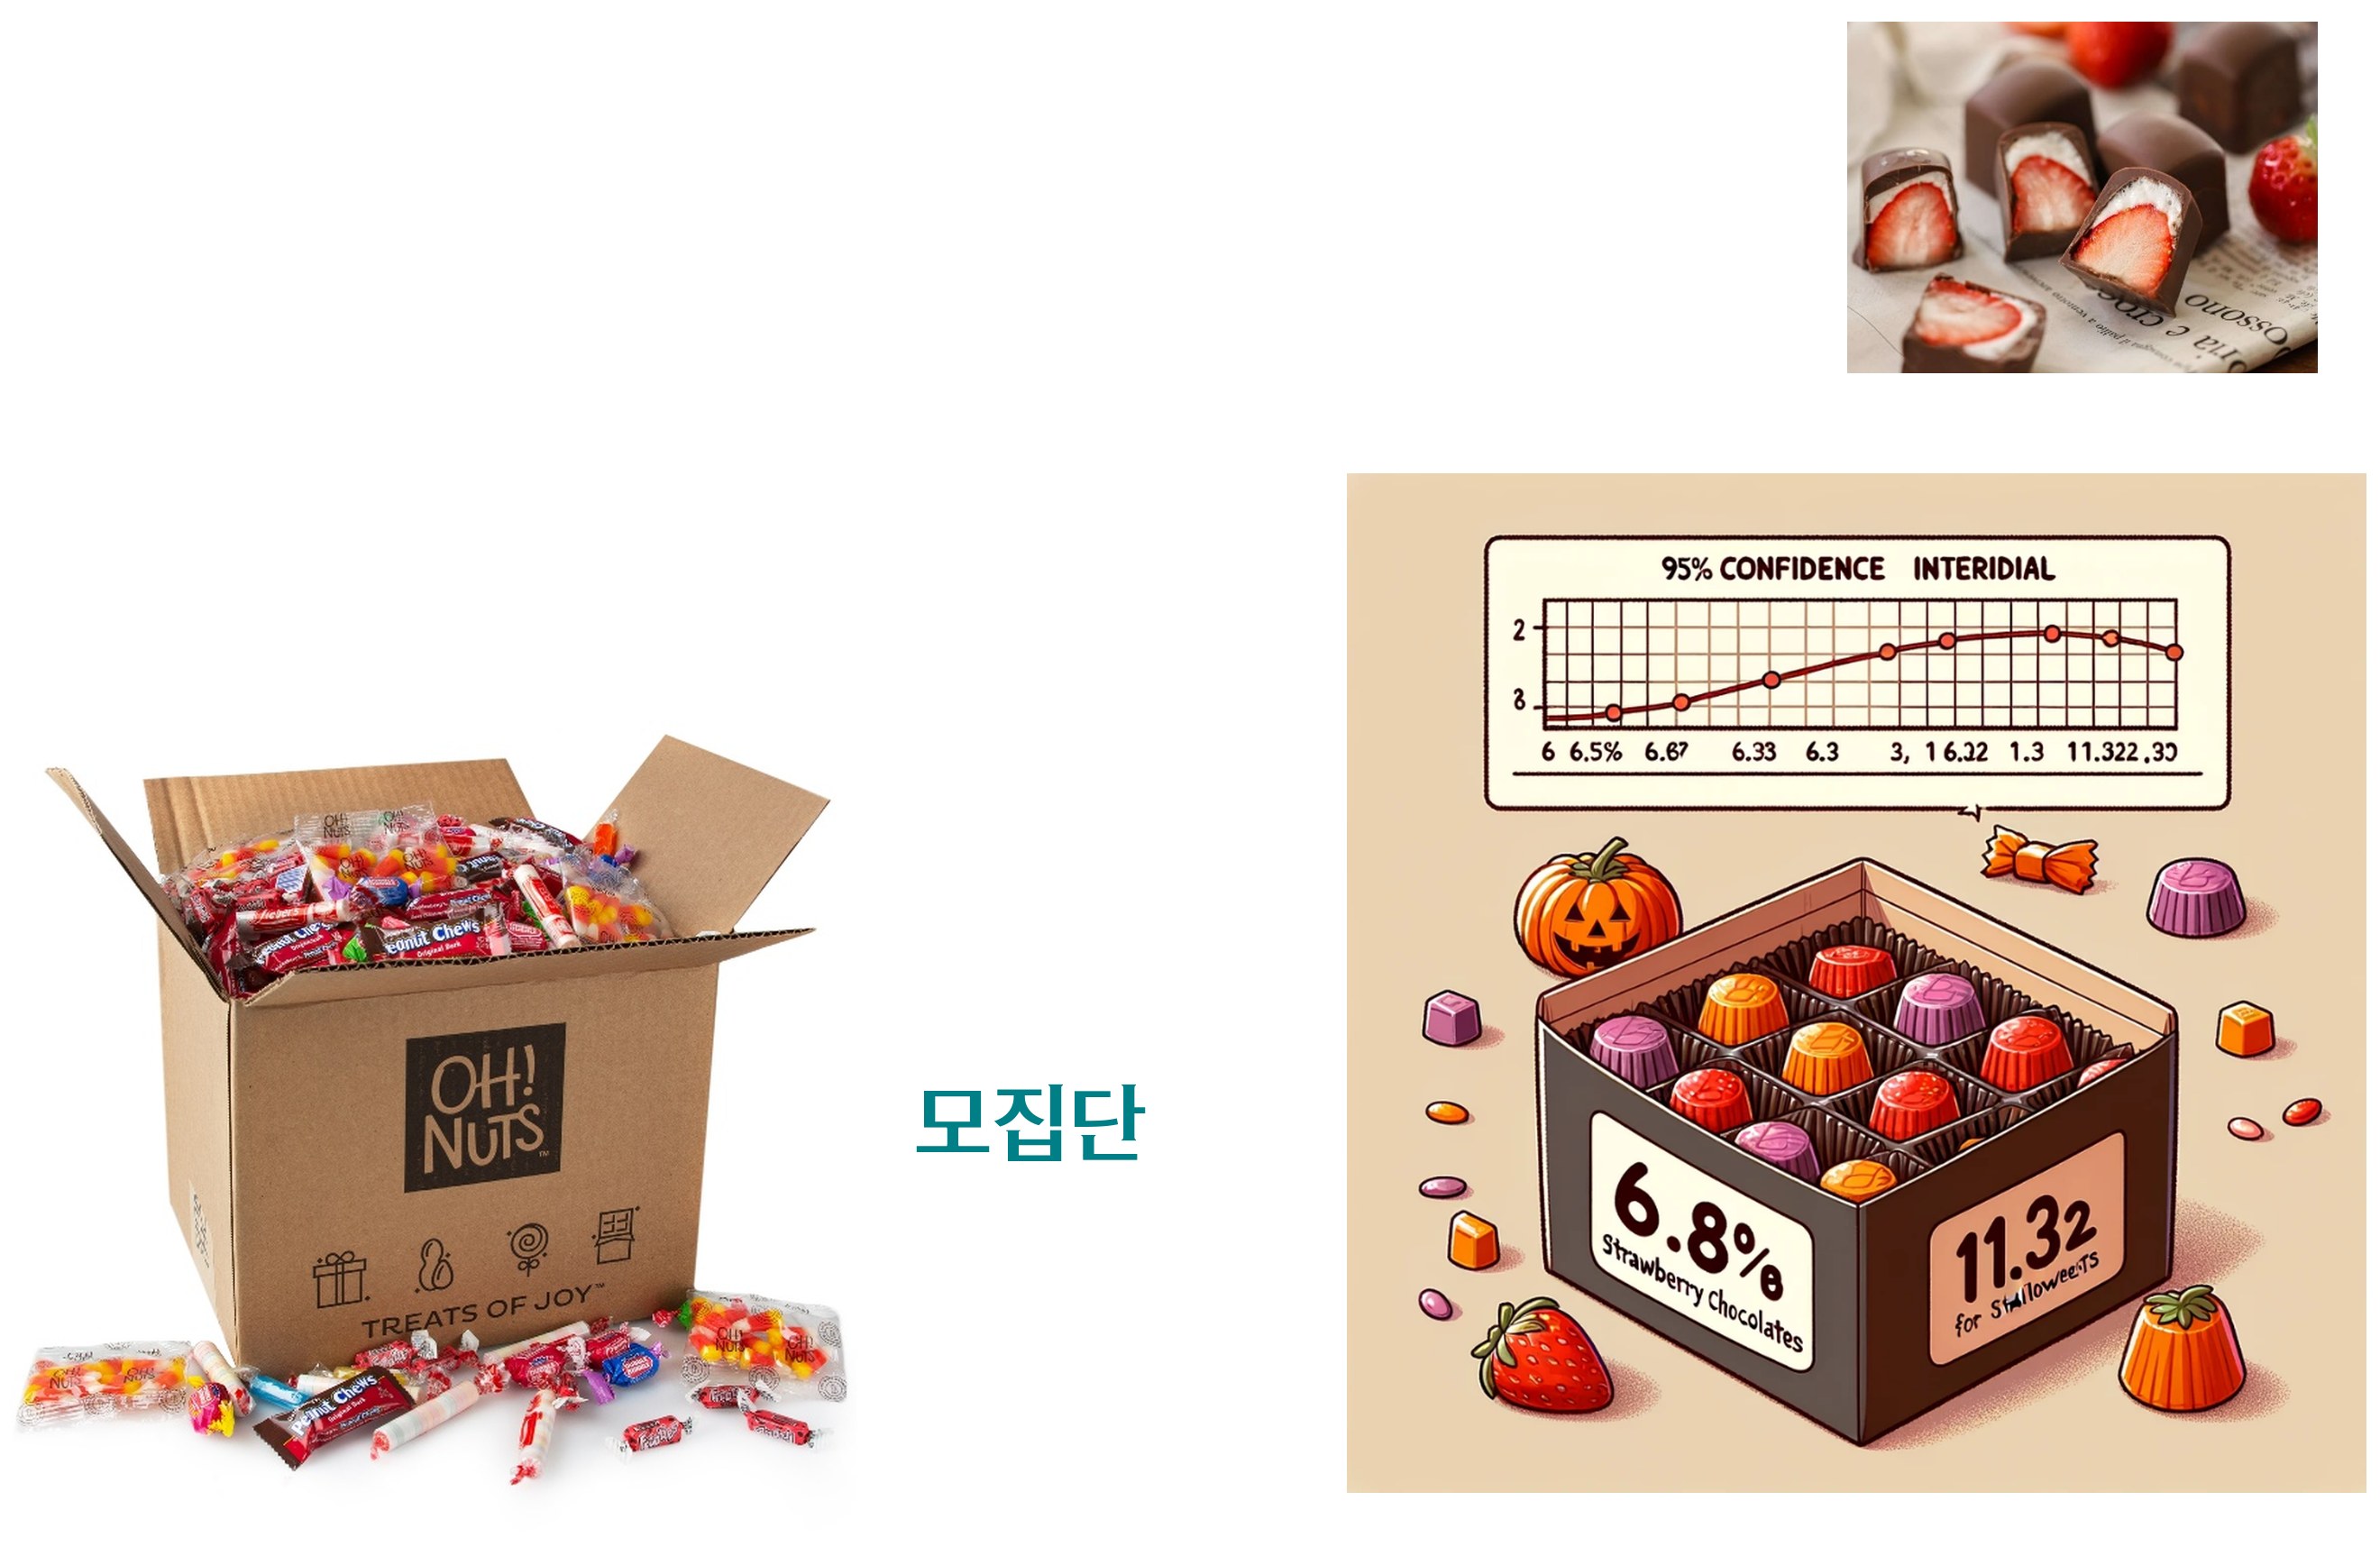
원본 화면의 보조 문구
71 / 77
추론통계학 · 17/23
72. 추론통계학의 시작 : 표본추출과 추정
표본추출량의 특성
정의 3-1 모집단, 표본, 모수, 통계량
- 1) 모집단 : 관심의 대상이 되는 전체집단
- 2) 표본 : 모집단의 부분집합
- 3) 모수 : 모집단의 특성치(예: 모평균, 모비율, 모분산 등)
- 4) 통계량 : 표본의 특성치(예: 표본평균, 표본비율, 표본분산 등)
원본 화면의 보조 문구
72 / 77
추론통계학 · 18/23
73. 추론통계학: 사탕 샘플 통계로 모집단(사탕상자) 추정하기
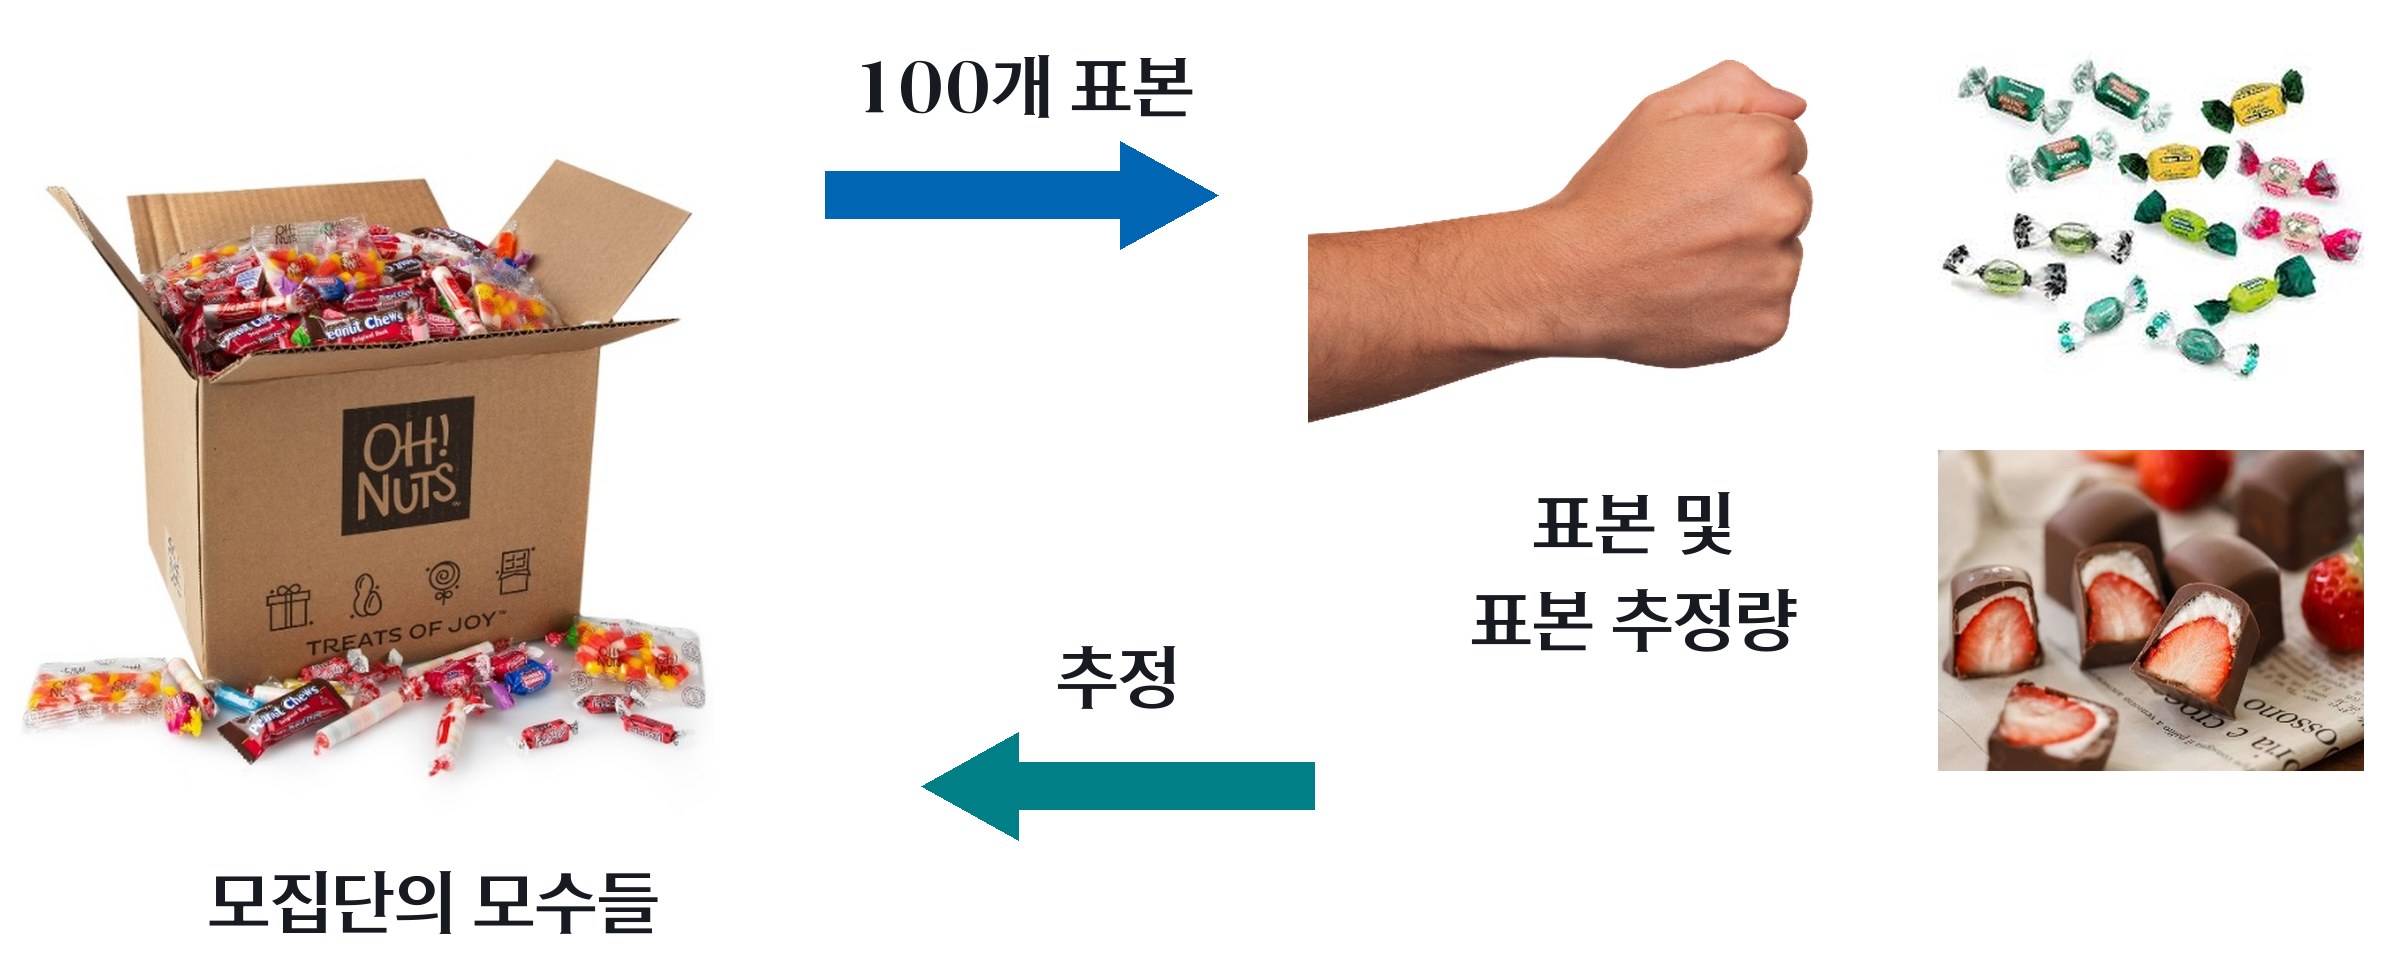
“표본의 통계량으로 모집단의 모수를 ‘추정’한다” = “내 주먹 사탕 100개로 사탕박스의 사탕 분포를 ‘추정’한다”
| 정의 3-1 · 모집단, 표본, 모수, 통계량 | 사탕 예 |
|---|---|
| 모집단 : 관심의 대상이 되는 전체집단 | (사탕 상자 전체) |
| 표본 : 모집단의 부분집합 | (딸기 초콜릿을 포함한, 내가 주먹으로 뽑은 한움큼) |
| 모수 : 모집단의 특성치(예: 모평균, 모비율, 모분산 등) | (사탕 상자 전체 각 사탕의 평균, 빈도수 등) |
| 통계량 : 표본의 특성치(예: 표본평균, 표본비율, 표본분산 등) | (내 주먹안의 각 사탕의 평균, 빈도수 등) |
원본 화면의 보조 문구
73 / 77
추론통계학 · 19/23
74. 추론통계학의 전제1. 모집단은 ‘정확하게’ 알 수 없다
“표본의 통계량으로 모집단의 모수를 ‘추정’한다” = “내 주먹 사탕 100개로 사탕박스의 사탕 분포를 ‘추정’한다”
“내 주먹 사탕 100개로 사탕박스의 사탕 분포를 ‘추정’한다”
= 다시 말하자면, 사탕 상자에 딸기 초콜릿이 ‘정확히 몇 개인지’ 아는 것은 불가능하다
(통계학의 가장 중요한 전제 중 하나)
원본 화면의 보조 문구
74 / 77
추론통계학 · 20/23
75. 추론통계학의 전제2. 틀릴 확률이 항상 있다
# t.test를 사용하여 신뢰구간 계산
t.test(candy_data$Strawberry_Chocolate)$conf.int
t.test결과
> t.test(candy_data$Strawberry_Chocolate)$conf.int
[1]  6.677059 11.322941
attr(,"conf.level")
[1] 0.95
즉, 전체 상자에는 딸기 초콜릿이 6.68개~11.32개 사이의 딸기 초콜릿이 있을 확률이 95%다
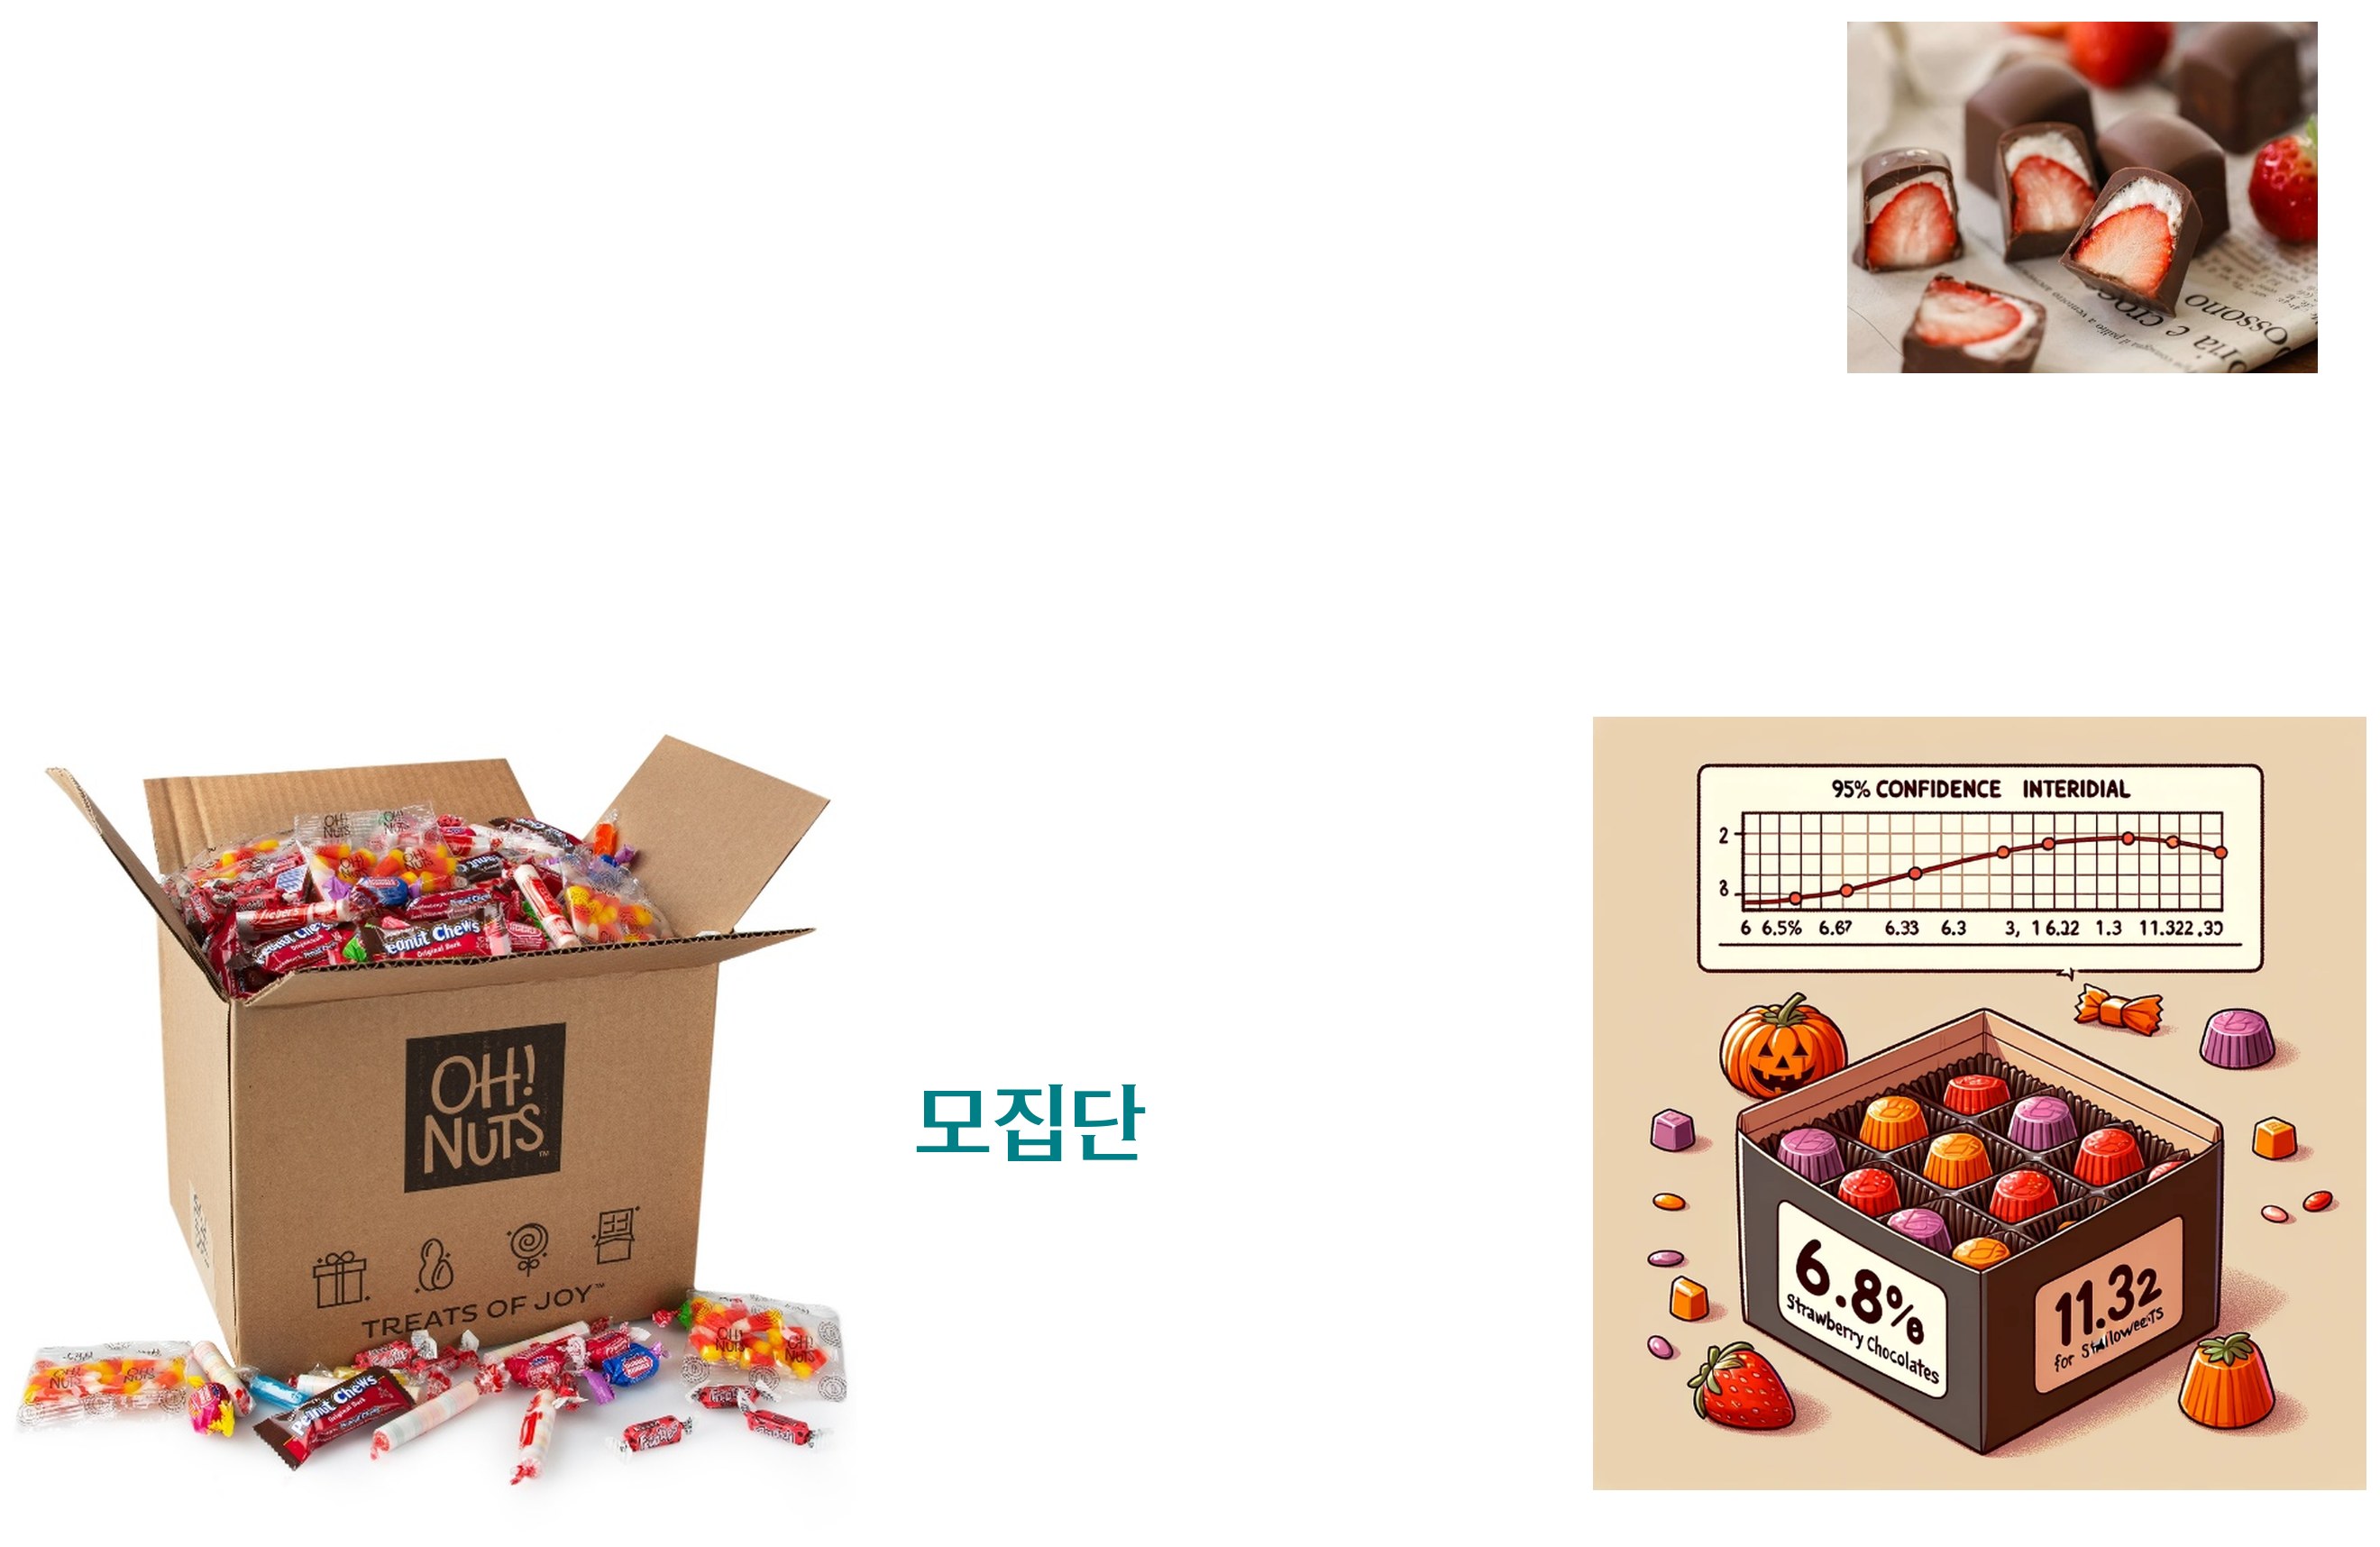
→ 5% 확률로 내가 틀릴 수도 있다 (안 틀릴 확률은 아예 없다)
원본 화면의 보조 문구
75 / 77
추론통계학 · 21/23
76. 추론통계학의 전제3. ‘표준오차’가 존재한다 (내가 틀린 정도를 나타내는 숫자)
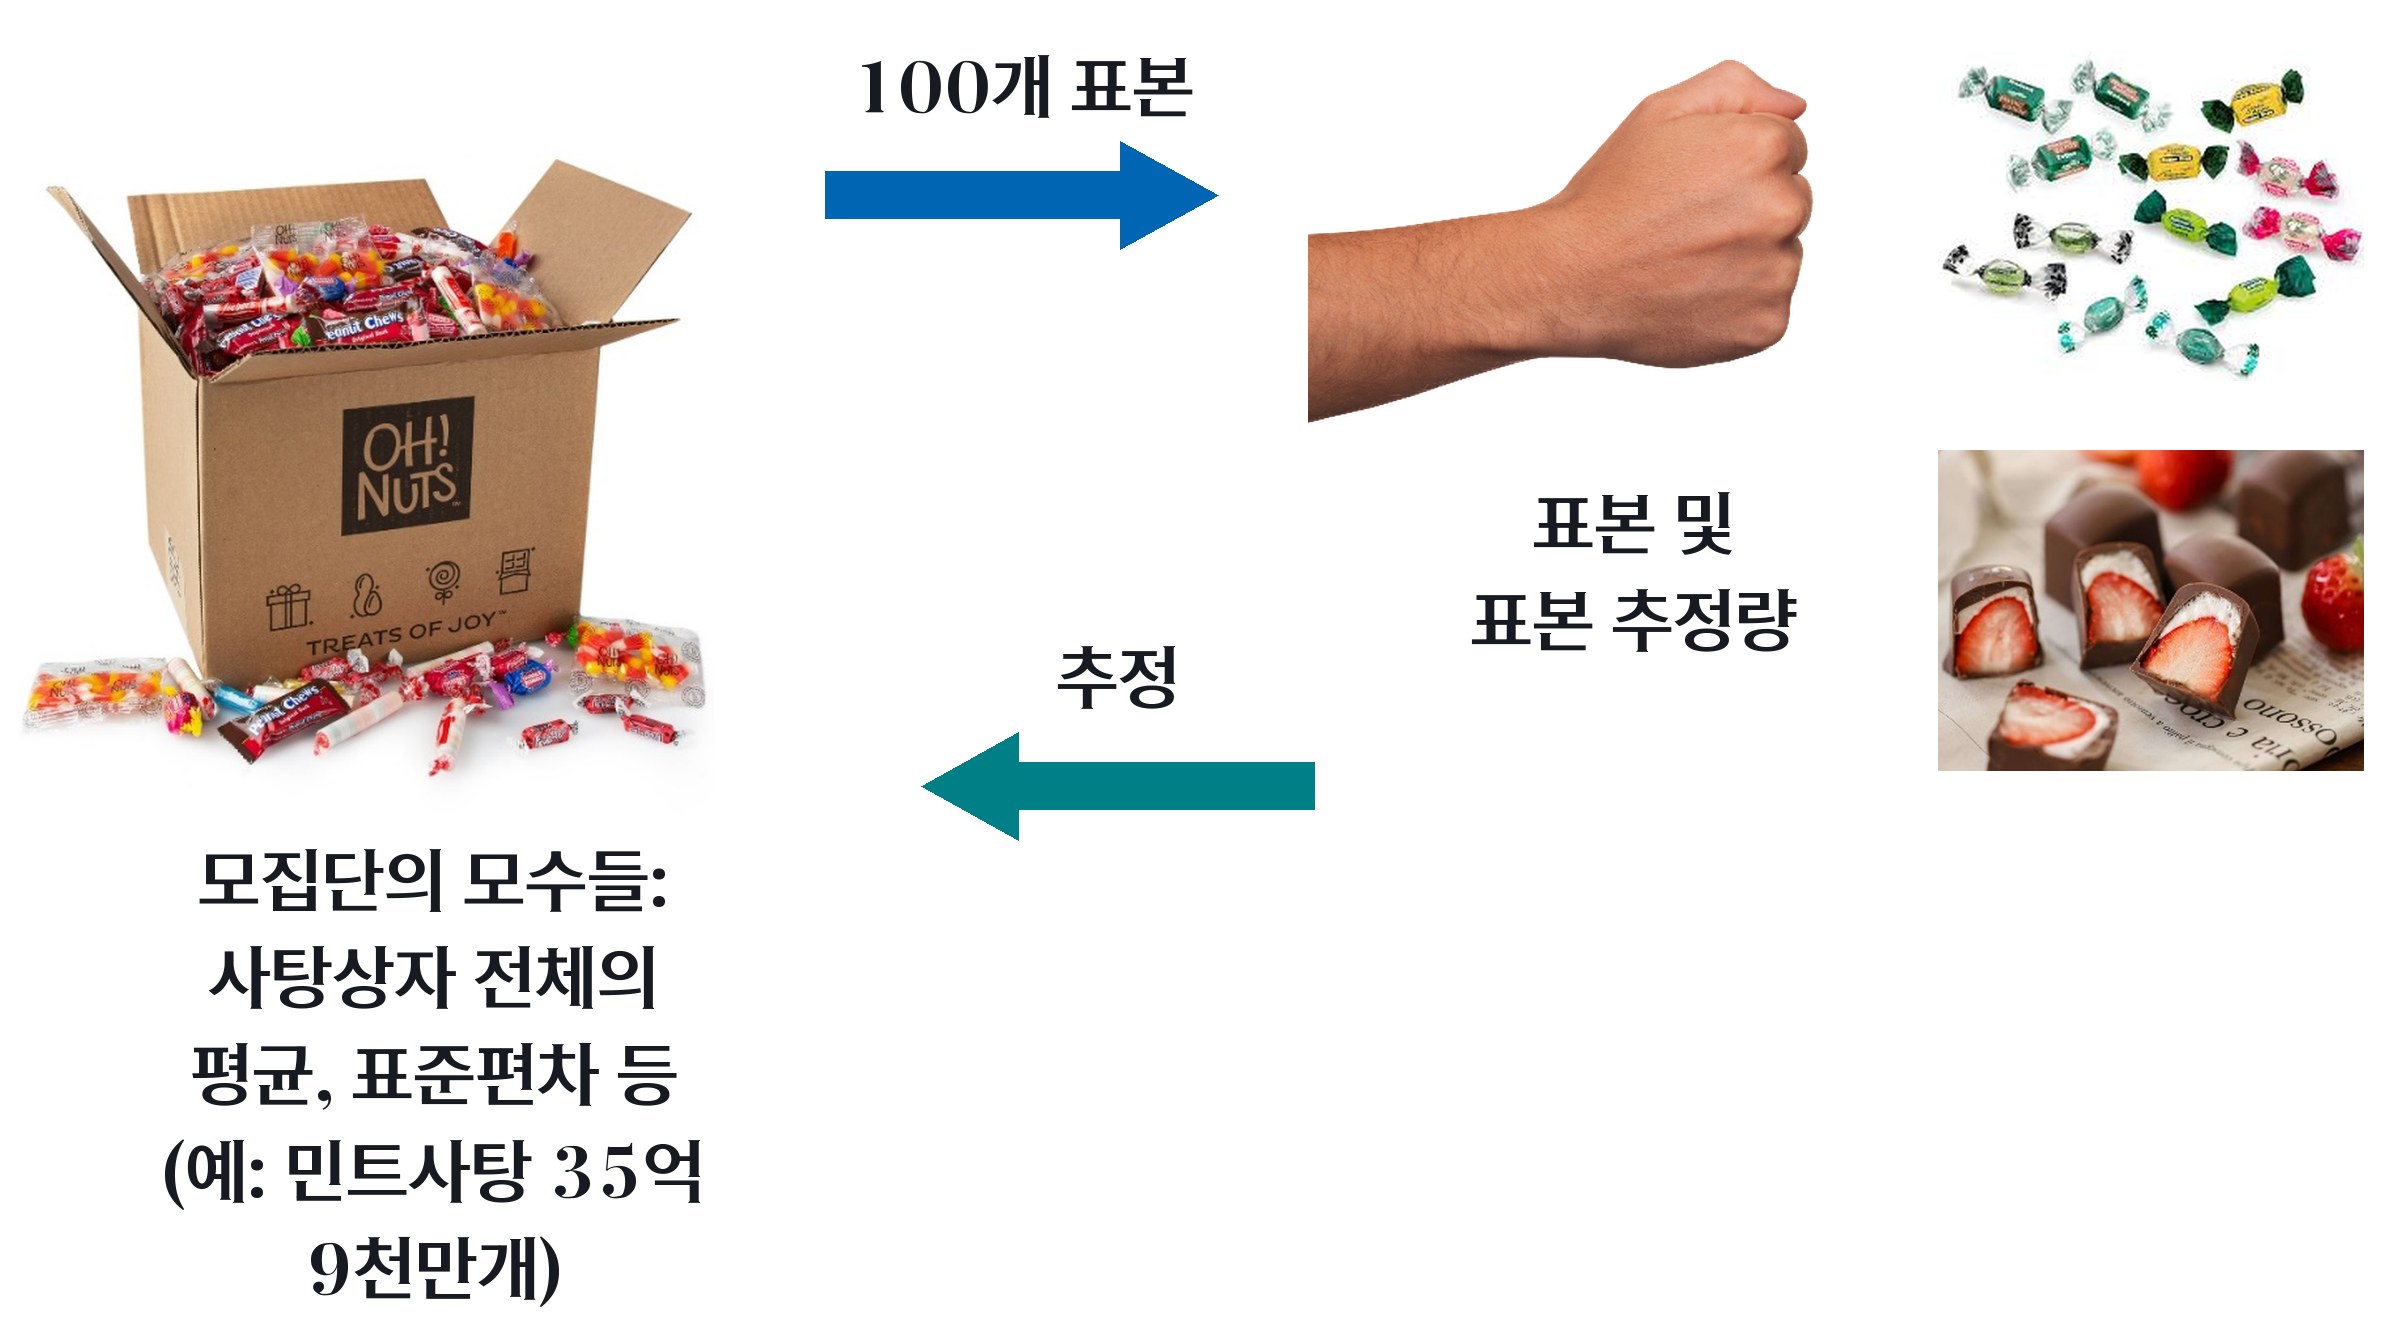
“표본의 통계량으로 모집단의 모수를 ‘추정’한다” = “내 주먹 사탕 100개로 사탕박스의 사탕 분포를 ‘추정’한다”
(예: 내 주먹 사탕 100개로 추정한 모집단의 민트사탕 개수 = 34억 개)
- 어라, 실제 개수는 35억 9천만개인데 내가 예측한 34억개랑 틀리네?
- 표준오차 : “내가 얼마나 틀렸는가”를 나타내는 정도를 숫자로 표현한 것 (모집단의 모수와 샘플의 기술통계량으로 추정한 모수와의 차이의 정도)
원본 화면의 보조 문구
76 / 77
추론통계학 · 22/23
77. 추론통계학의 기본 총정리
- 모집단의 특정한 모수 (예: 상자 안의 딸기초콜릿 전체갯수)를 완벽하게 아는건 불가능하다
- 모집단 (상자 안)을 다 뒤지는 건 무식하고 비효율적인 방법이다
- 내 손바닥 안에 있는 사탕만 세본 다음에 내 손바닥 사탕의 “패턴”으로 원래 상자를 “추정”한다
- “추정”하기 때문에 완벽한 정답은 알 수 없다 (확률로 추측한다)
- “(모집단을 완벽하게 추측하지 못하고) 내가 틀린 정도” = 표준 오차다.
모집단
상자에 “딸기초콜릿만” 몇 개인지 알고싶어
설마 이 상자를 다 뜯어서 일일히 세보려구요?
원본 화면의 보조 문구
77 / 77
추론통계학 · 23/23